




Kiểm tra bot AI trong robots.txt trước khi sửa nội dung để làm GEO
Một dòng Disallow: / cũ trong robots.txt có thể đang âm thầm chặn mọi bot AI ghé website. Nhiều tệp robots.txt được viết từ trước khi các công cụ AI tạo sinh gửi bot đi đọc trang, nên không ai để ý tới tác động của chúng. Kiểm tra bot AI trước khi làm GEO, tức tối ưu để công cụ AI chọn và trích dẫn nội dung, giúp bạn biết chắc website đang mở hay đóng với từng bot. Phần dưới giải thích cách đọc kết quả, dựa trên các bài về robots.txt của blog SEONGON.
Robots.txt có bốn lệnh, và bot luôn đọc nhóm viết riêng cho mình trước
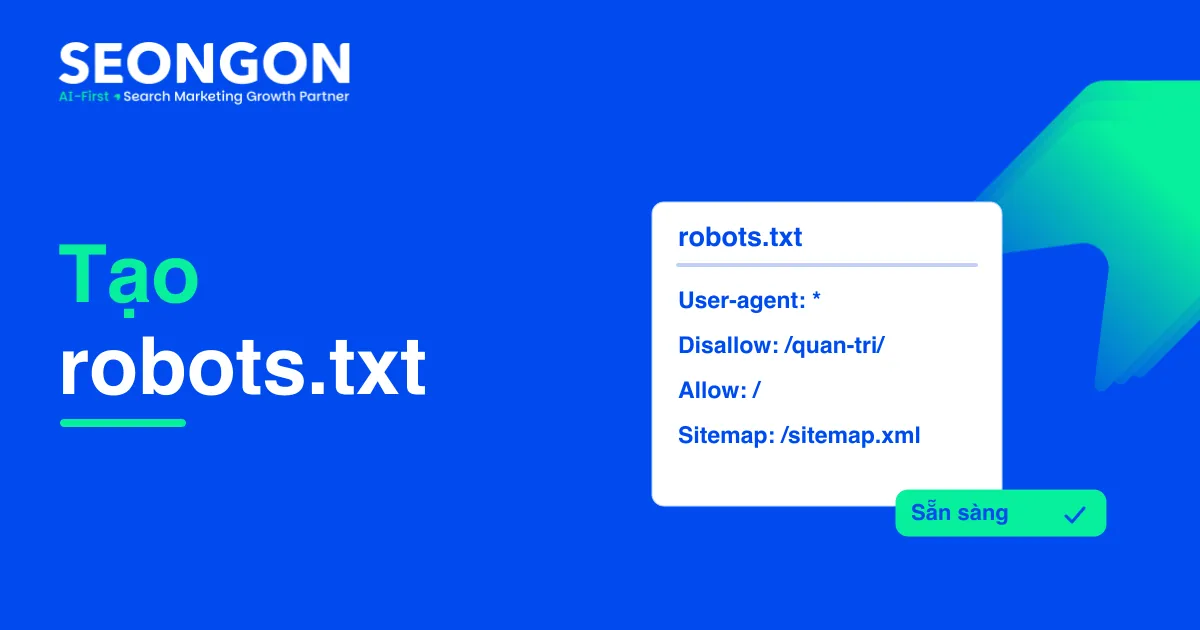
Mỗi kết quả được vào hay bị chặn đều bắt nguồn từ bốn lệnh cơ bản trong robots.txt. Bài File robots.txt là gì của SEONGON giải thích bốn lệnh này như sau:

- User-agent cho biết các dòng bên dưới áp dụng cho bot nào, còn dấu * nghĩa là mọi bot.
- Disallow cấm bot vào một đường dẫn hoặc một thư mục.
- Allow mở quyền vào một đường dẫn, kể cả khi đường dẫn đó nằm trong thư mục đã bị cấm.
- Sitemap chỉ vị trí tệp sơ đồ trang web để bot tìm trang dễ hơn.
Công cụ chọn luật theo đúng thứ tự mà bot dùng. Công cụ tìm nhóm User-agent nêu đúng tên bot trước, nếu không có mới dùng nhóm chung User-agent: *. Trong nhóm đó, dòng có đường dẫn khớp dài nhất sẽ thắng, và Allow thắng Disallow khi hai đường dẫn dài bằng nhau. Vì vậy, một nhóm riêng cho GPTBot sẽ thay hoàn toàn nhóm chung, kể cả những dòng chặn thư mục quản trị.
Nguồn: File robots.txt là gì? 2 cách tạo vào gửi file robots.txt chuẩn, blog SEONGON.
Tám bot AI được kiểm làm những việc khác nhau, và hai tên không phải bot
Quyết định chặn hay mở một bot nên dựa trên việc bot đó làm, không dựa trên tên hãng. GPTBot của OpenAI thu thập dữ liệu để huấn luyện mô hình, OAI-SearchBot thu thập để đưa trang vào kết quả tìm kiếm của ChatGPT, còn ChatGPT-User chỉ tải trang khi người dùng yêu cầu. Theo tài liệu của OpenAI, robots.txt có thể không áp dụng cho lượt tải của ChatGPT-User. ClaudeBot của Anthropic, PerplexityBot của Perplexity và CCBot của Common Crawl, tổ chức xây kho dữ liệu web mở, đều là bot tự động và tôn trọng robots.txt. Google-Extended và Applebot-Extended chỉ là tên khai báo trong robots.txt để quyết định nội dung có được dùng huấn luyện AI hay không, nên chặn hai tên này không ảnh hưởng tới tìm kiếm thường. Mô tả từng bot lấy từ tài liệu của OpenAI, Anthropic, Perplexity, Apple và Common Crawl.
Robots.txt chỉ là lời đề nghị, không khóa được bot và không giấu được trang
Bot tuân thủ chuẩn sẽ làm theo robots.txt, nhưng không có cơ chế nào bắt buộc mọi bot phải làm theo. Bài File robots.txt là gì nêu hai giới hạn của tệp này. Thứ nhất, trang bị chặn vẫn có thể hiện trên Google nếu trang khác liên kết tới, vì bot thấy đường dẫn dù không đọc được nội dung. Thứ hai, robots.txt không bảo vệ được nội dung nhạy cảm, nên bạn cần thêm mật khẩu, thẻ noindex báo Google không đưa trang vào kết quả, hoặc gỡ hẳn trang.

Chặn nhầm thì gây hại theo chiều ngược lại, vì trang quan trọng mất cơ hội xuất hiện. Bài 40+ lỗi technical SEO phổ biến khuyên chỉ chặn những phần không cần như thư mục quản trị hay thư mục tạm, và không để robots.txt mâu thuẫn với thẻ noindex. Muốn biết bot nào thật sự đã ghé, bạn đối chiếu bằng công cụ phân tích log truy cập. Muốn sửa lại quy tắc, bạn dùng công cụ tạo robots.txt.
Nguồn: File robots.txt là gì? 2 cách tạo vào gửi file robots.txt chuẩn, blog SEONGON.