



Head of Innovation - SEO & GEO
Anh Nguyễn Văn Phúc là Giám đốc Vận hành SEO & GEO. Hơn 10 năm kinh nghiệm nghiên cứu và triển khai SEO đa dạng lĩnh vực, ngành nghề như:…
AI Search Growth Solution
Theo tỉnh thành
Ads Growth Solution
Dịch vụ khác
Dịch vụ đào tạo
Kiến thức
Tài liệu - Ebook
Tools
Robots.txt là một trong những tệp đầu tiên SEOer cần kiểm tra khi tiếp nhận website. Chỉ một dòng lệnh đặt sai trong tệp này cũng có thể khiến Google ngừng thu thập cả trang. Bài viết giúp bạn hiểu robots.txt là gì, cách tệp hoạt động, cách tạo và gửi tệp cho Google cùng những lỗi thường gặp cần tránh.
Trước khi tạo hay chỉnh sửa, bạn cần nắm rõ robots.txt là tệp gì và nằm ở đâu. Phần này cũng hướng dẫn cách kiểm tra website của bạn đã có tệp này hay chưa.
Robots.txt là tệp văn bản thuần nằm ở thư mục gốc của website, chứa các chỉ dẫn cho trình thu thập dữ liệu của công cụ tìm kiếm như Googlebot, Bingbot. Tệp hoạt động theo Giao thức loại trừ rô-bốt (Robots Exclusion Protocol). Nhờ đó, bot biết đường dẫn nào được phép thu thập dữ liệu (crawl) và đường dẫn nào nên bỏ qua.
Bạn có thể hiểu robots.txt là bộ quy tắc truy cập dành riêng cho bot. Khi ghé một website, việc đầu tiên bot làm là đọc tệp này để biết phạm vi được phép đi vào. Sau đó bot mới thu thập các trang bên trong.
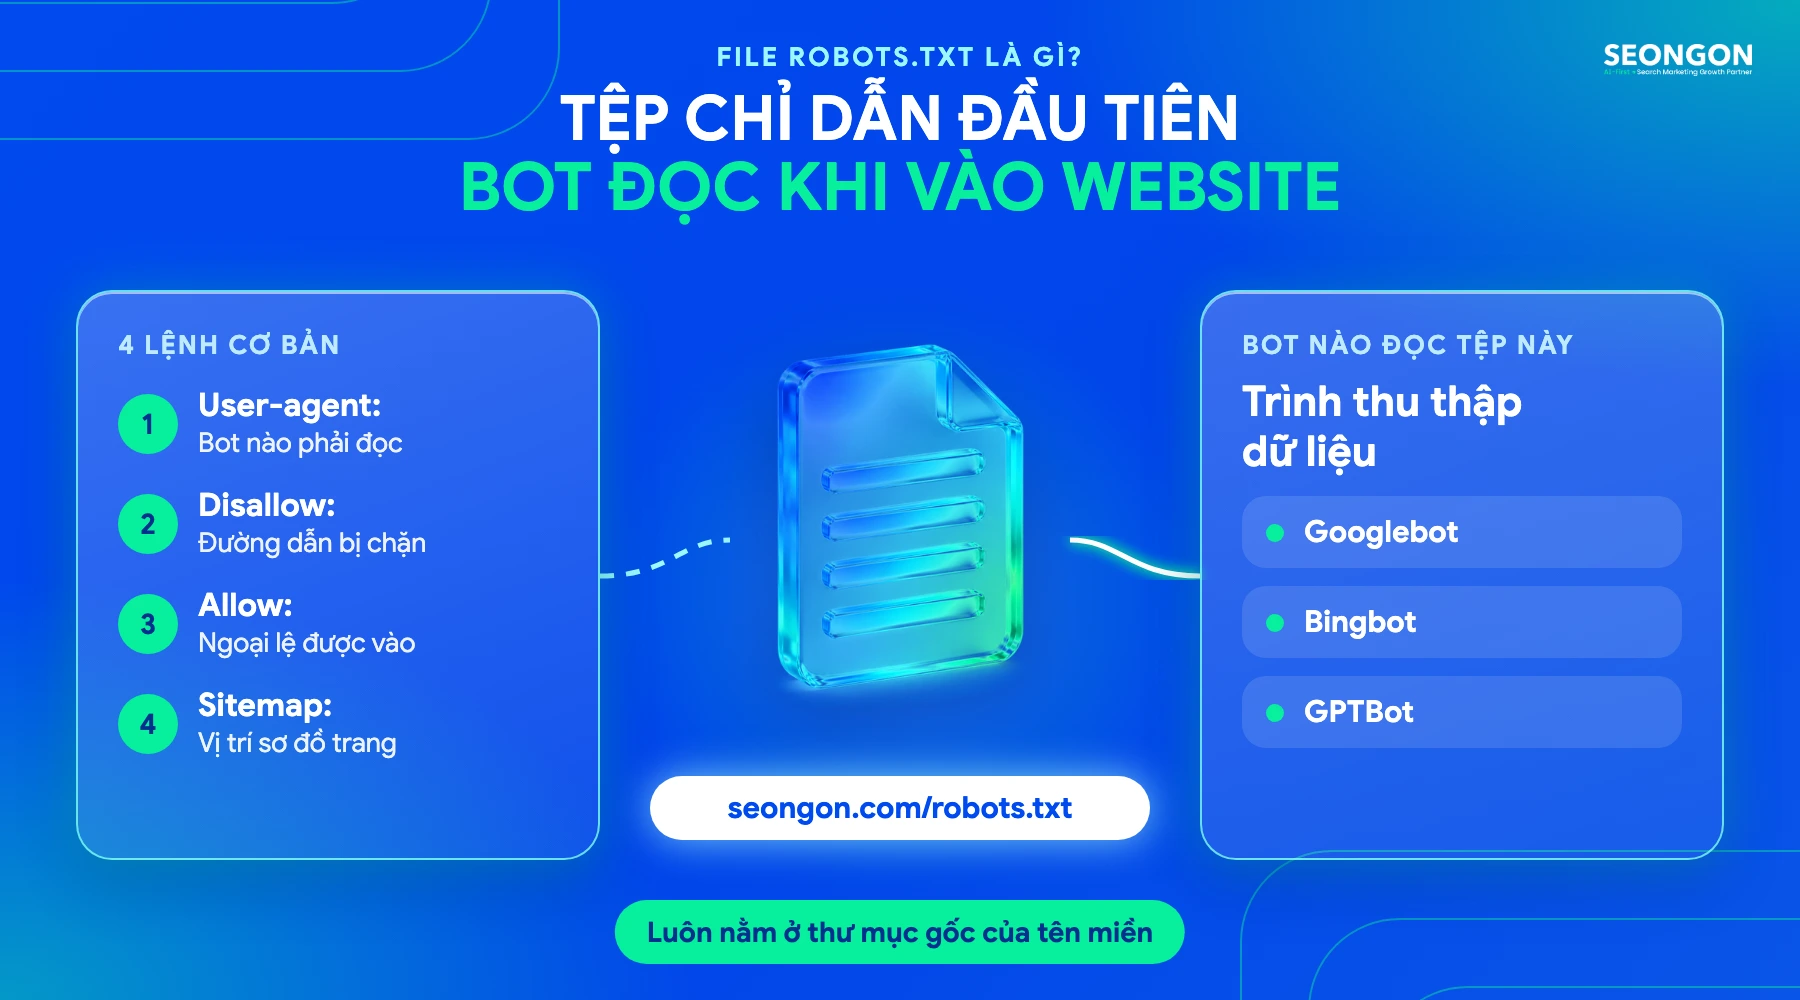
File robots.txt bắt buộc phải đặt ở thư mục gốc của tên miền để công cụ tìm kiếm tìm thấy. Đường dẫn của tệp luôn có dạng tên miền cộng thêm /robots.txt, ví dụ:
https://seongon.com/robots.txt
Nếu đặt tệp trong thư mục con, chẳng hạn https://seongon.com/blog/robots.txt, bot sẽ không đọc tệp đó và coi như website không có quy tắc nào. Bạn cũng cần lưu ý mỗi tệp chỉ có hiệu lực với đúng tên miền, giao thức và cổng nơi nó được lưu. Ví dụ tệp ở https://example.com/robots.txt không áp dụng cho tên miền con https://m.example.com/.
Bạn có thể kiểm tra nhanh website đã có robots.txt hay chưa ngay trên trình duyệt mà không cần công cụ nào khác. Để kiểm tra, bạn hãy thực hiện theo các bước sau:
Bước 1: Bạn mở trình duyệt, nhập tên miền chính của website rồi gõ thêm /robots.txt vào cuối thanh địa chỉ, ví dụ seongon.com/robots.txt.
Bước 2: Bạn nhấn Enter và xem nội dung trang hiện ra.
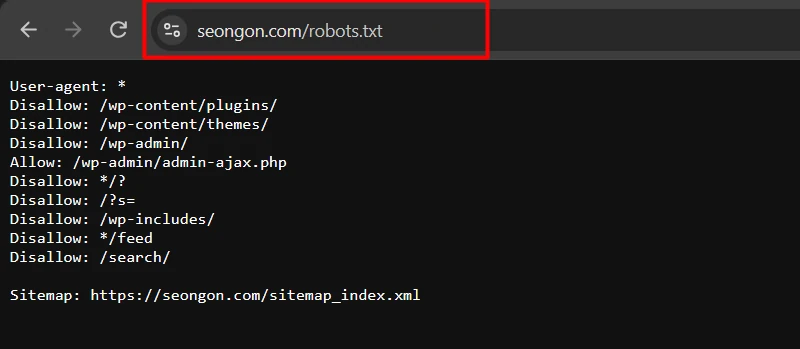
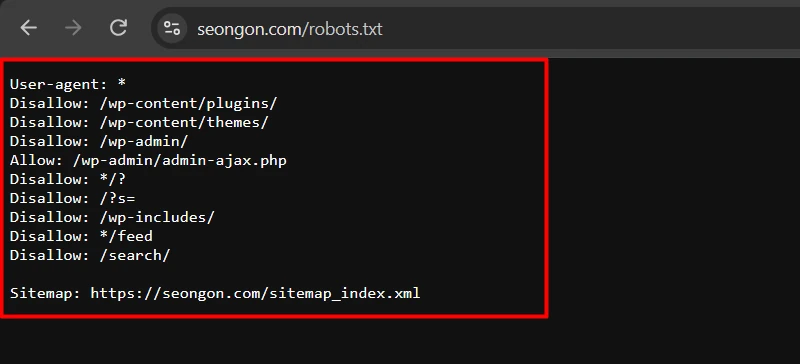
Nếu trang hiển thị các dòng lệnh bắt đầu bằng User-agent như ảnh dưới, website đã có robots.txt và tệp đang hoạt động. Ngược lại, nếu trình duyệt báo lỗi 404, website chưa có tệp này và Google sẽ hiểu là được phép thu thập toàn bộ trang.
Robots.txt hoạt động theo một trình tự cố định: bot đọc tệp trước, so từng URL với các quy tắc rồi mới quyết định có thu thập hay không. Bốn nguyên tắc dưới đây giúp bạn đoán đúng bot sẽ làm gì với website của mình.
Trước khi thu thập bất kỳ trang nào, Googlebot và các bot tìm kiếm khác sẽ tải file robots.txt ở thư mục gốc. Google thường lưu bản tệp này trong bộ nhớ đệm tối đa 24 giờ, vì vậy thay đổi bạn vừa sửa có thể chưa được áp dụng ngay.
Sau khi đọc tệp, bot so từng URL định truy cập với các dòng Allow và Disallow. Nếu URL được phép, bot tiếp tục thu thập trang và đi theo các liên kết bên trong. Nếu URL bị chặn, bot bỏ qua đường dẫn đó và chuyển sang những URL khác.
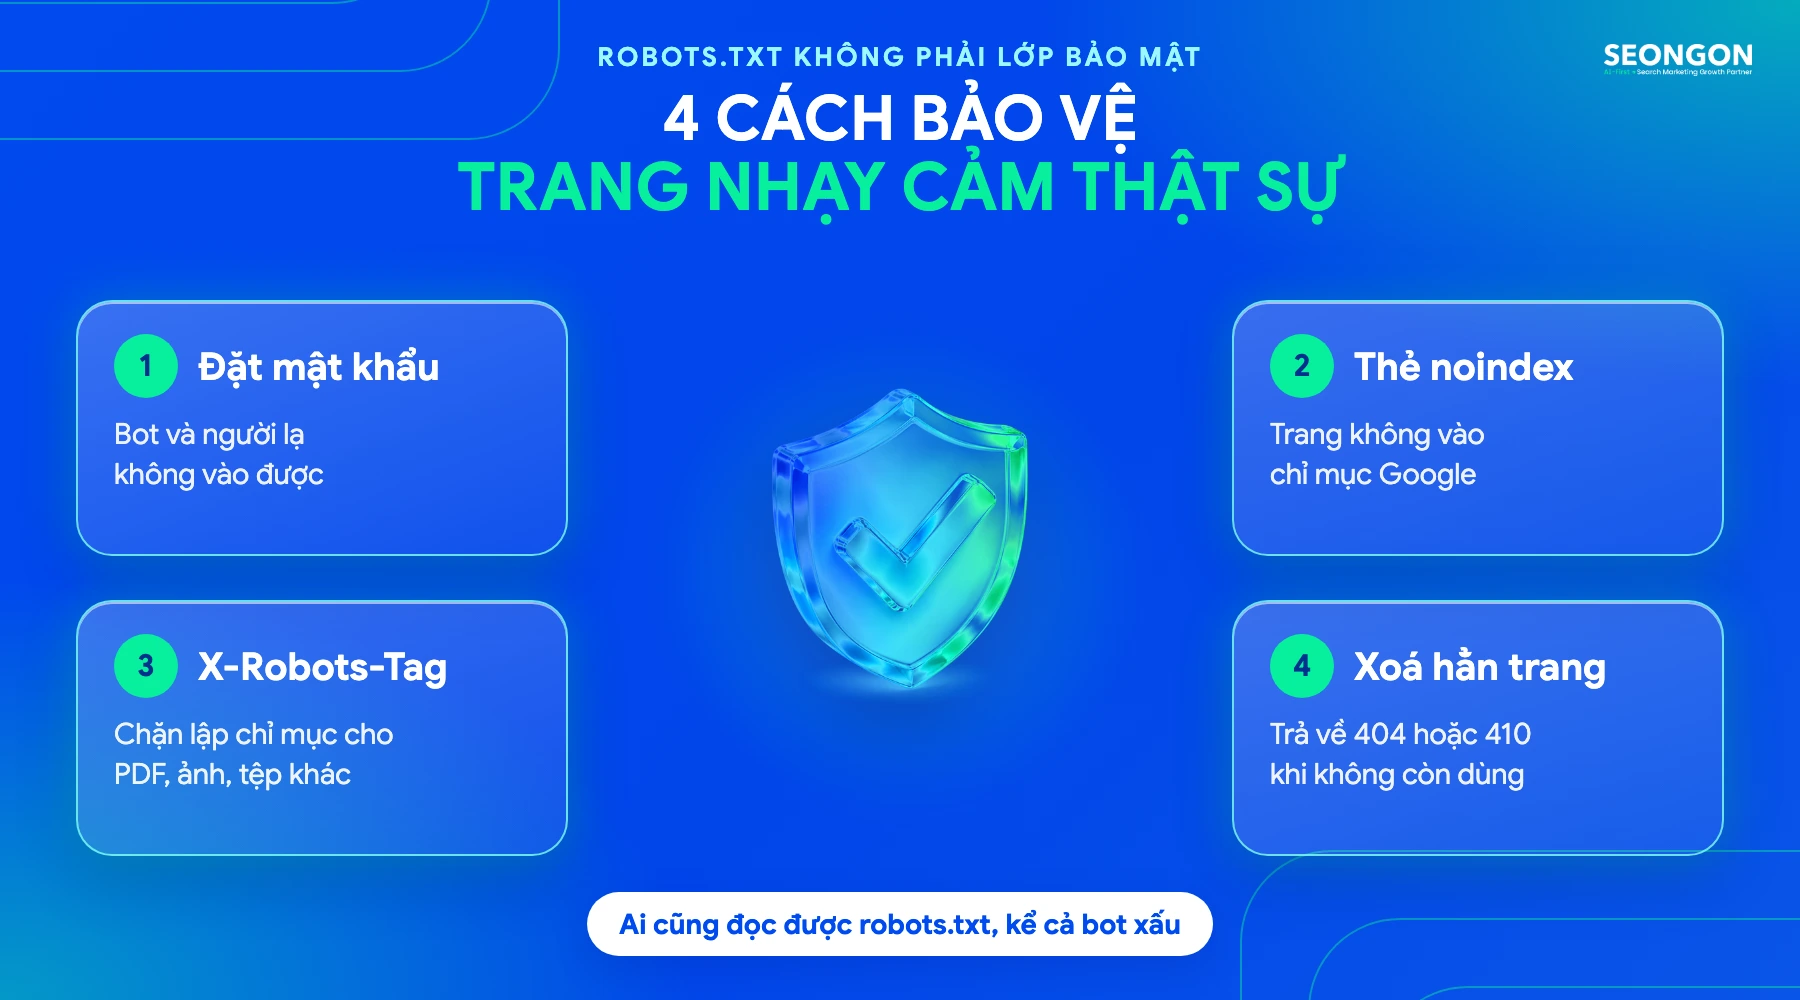
Giao thức loại trừ rô-bốt hoạt động theo cơ chế tự nguyện. Bot của Google, Bing làm theo quy tắc trong robots.txt, còn công cụ cào dữ liệu trái phép hay bot rác có thể bỏ qua hoàn toàn. Vì vậy bạn không thể dùng robots.txt để bảo vệ dữ liệu.
Khi hai quy tắc cùng khớp với một URL, Google áp dụng quy tắc có đường dẫn dài hơn, tức cụ thể hơn. Ví dụ bạn chặn cả thư mục /wp-admin/ nhưng cho phép /wp-admin/admin-ajax.php, Googlebot vẫn truy cập được tệp admin-ajax.php. Nếu hai quy tắc dài bằng nhau, Google chọn quy tắc ít hạn chế hơn, tức Allow.
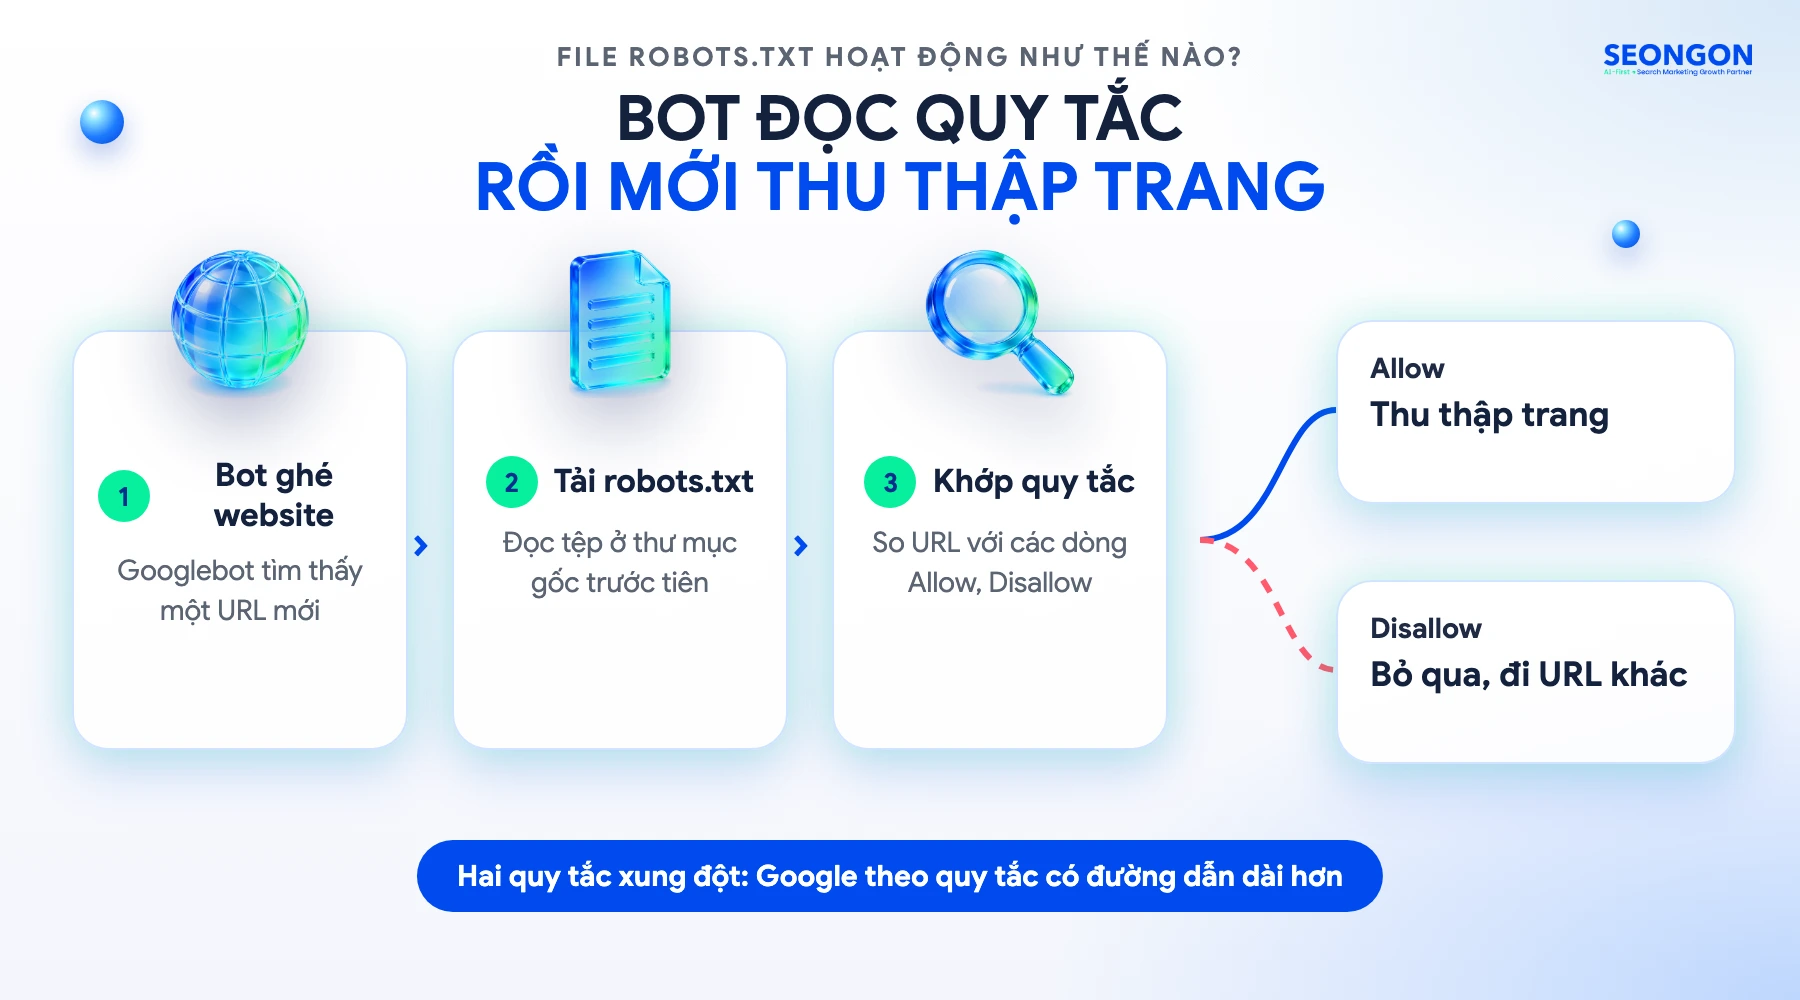
Một file robots.txt được viết bằng các nhóm quy tắc, mỗi nhóm bắt đầu bằng dòng User-agent. Phần này giải thích 4 lệnh cơ bản và một tệp mẫu hoàn chỉnh để bạn áp dụng cho website của mình.
Một file robots.txt hoàn chỉnh được xây dựng từ 4 lệnh nền tảng sau:
Google chỉ đọc 4 lệnh trên. Các lệnh khác như Crawl-delay hay Noindex sẽ bị Googlebot bỏ qua.
Dưới đây là một tệp robots.txt mẫu cho website WordPress, gồm quy tắc chung cho mọi bot, quy tắc riêng cho một bot và dòng khai báo sitemap:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
Disallow: /search/

User-agent: AhrefsBot
Disallow: /

Sitemap: https://example.com/sitemap_index.xml
Nhóm đầu tiên áp dụng cho tất cả bot. Tệp chặn khu vực quản trị /wp-admin/ nhưng mở riêng admin-ajax.php để Googlebot hiển thị đúng các phần nội dung tải động. Hai dòng chặn /?s= và /search/ giúp bot không tốn thời gian vào trang kết quả tìm kiếm nội bộ, vốn sinh ra vô số URL gần giống nhau.
Nhóm thứ hai chỉ áp dụng cho AhrefsBot, bot của công cụ phân tích backlink Ahrefs. Dòng Disallow: / chặn bot này thu thập toàn bộ website để giảm tải máy chủ. Bạn chỉ thêm nhóm này khi thật sự muốn chặn bot đó, vì website sẽ không còn được Ahrefs cập nhật dữ liệu.
Dòng cuối cùng khai báo sitemap bằng URL đầy đủ, giúp bot tìm thấy danh sách trang quan trọng ngay khi đọc tệp. Mỗi dòng chỉ ghi một lệnh, giữa các nhóm nên để một dòng trống cho dễ đọc.
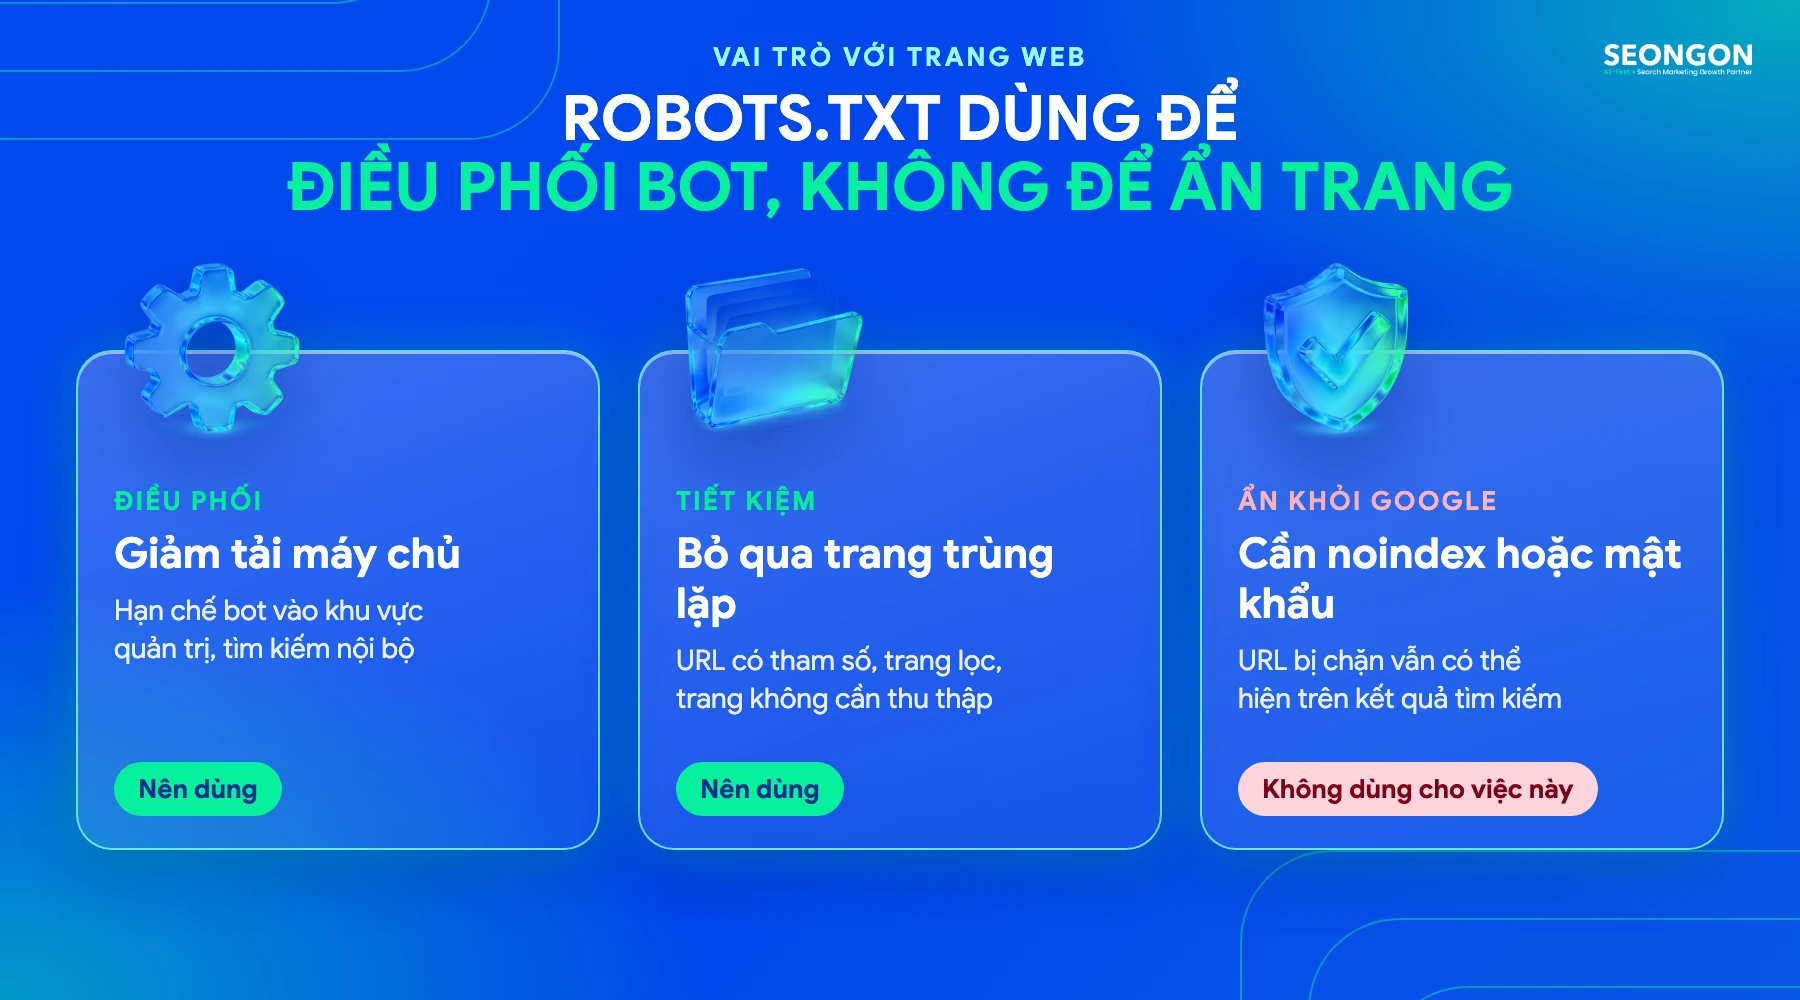
Theo tài liệu của Google Search Central, robots.txt chủ yếu dùng để quản lý lưu lượng thu thập dữ liệu, giúp máy chủ không bị quá tải. Tác dụng của tệp khác nhau với từng loại nội dung như sau.
Với trang HTML, robots.txt giúp bạn điều phối bot tập trung vào những trang quan trọng. Bạn có thể chặn khu vực quản trị, trang tìm kiếm nội bộ, URL có tham số lọc hoặc trang trùng lặp. Nhờ vậy máy chủ nhẹ hơn và bot dành thời gian cho những trang cần lên top.
Robots.txt không dùng để ẩn một trang khỏi Google. URL bị chặn vẫn có thể hiện trên kết quả tìm kiếm nếu có trang khác liên kết tới, chỉ là không kèm đoạn mô tả. Nếu không muốn trang xuất hiện trên Google, bạn cần dùng thẻ meta robots với giá trị noindex hoặc đặt mật khẩu cho trang.
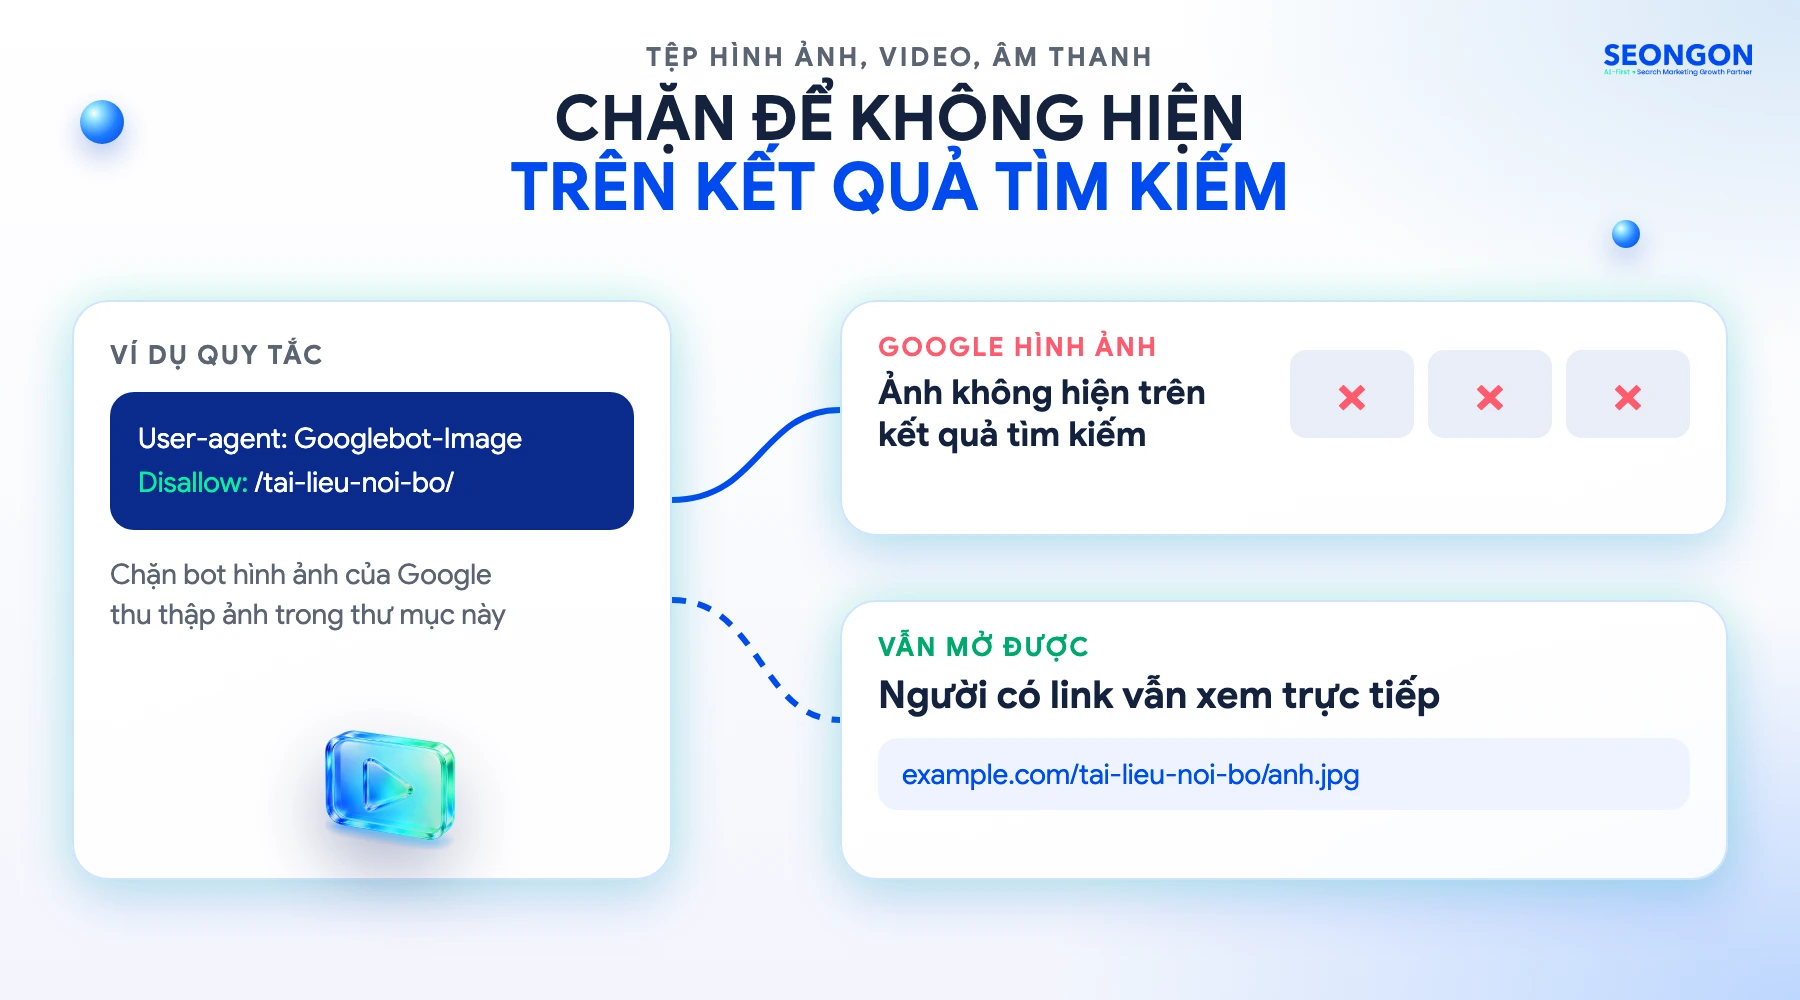
Với tệp hình ảnh, video và âm thanh, robots.txt có thể ngăn các tệp này xuất hiện trên kết quả tìm kiếm của Google. Ví dụ doanh nghiệp không muốn ảnh thiết kế nội bộ hiện trên Google Hình ảnh thì có thể chặn thư mục chứa các ảnh đó.
Việc chặn này chỉ khiến tệp không hiển thị trên kết quả tìm kiếm. Người dùng và website khác vẫn mở được tệp nếu có đường dẫn trực tiếp, vì vậy tài liệu cần bảo mật phải được bảo vệ bằng mật khẩu.
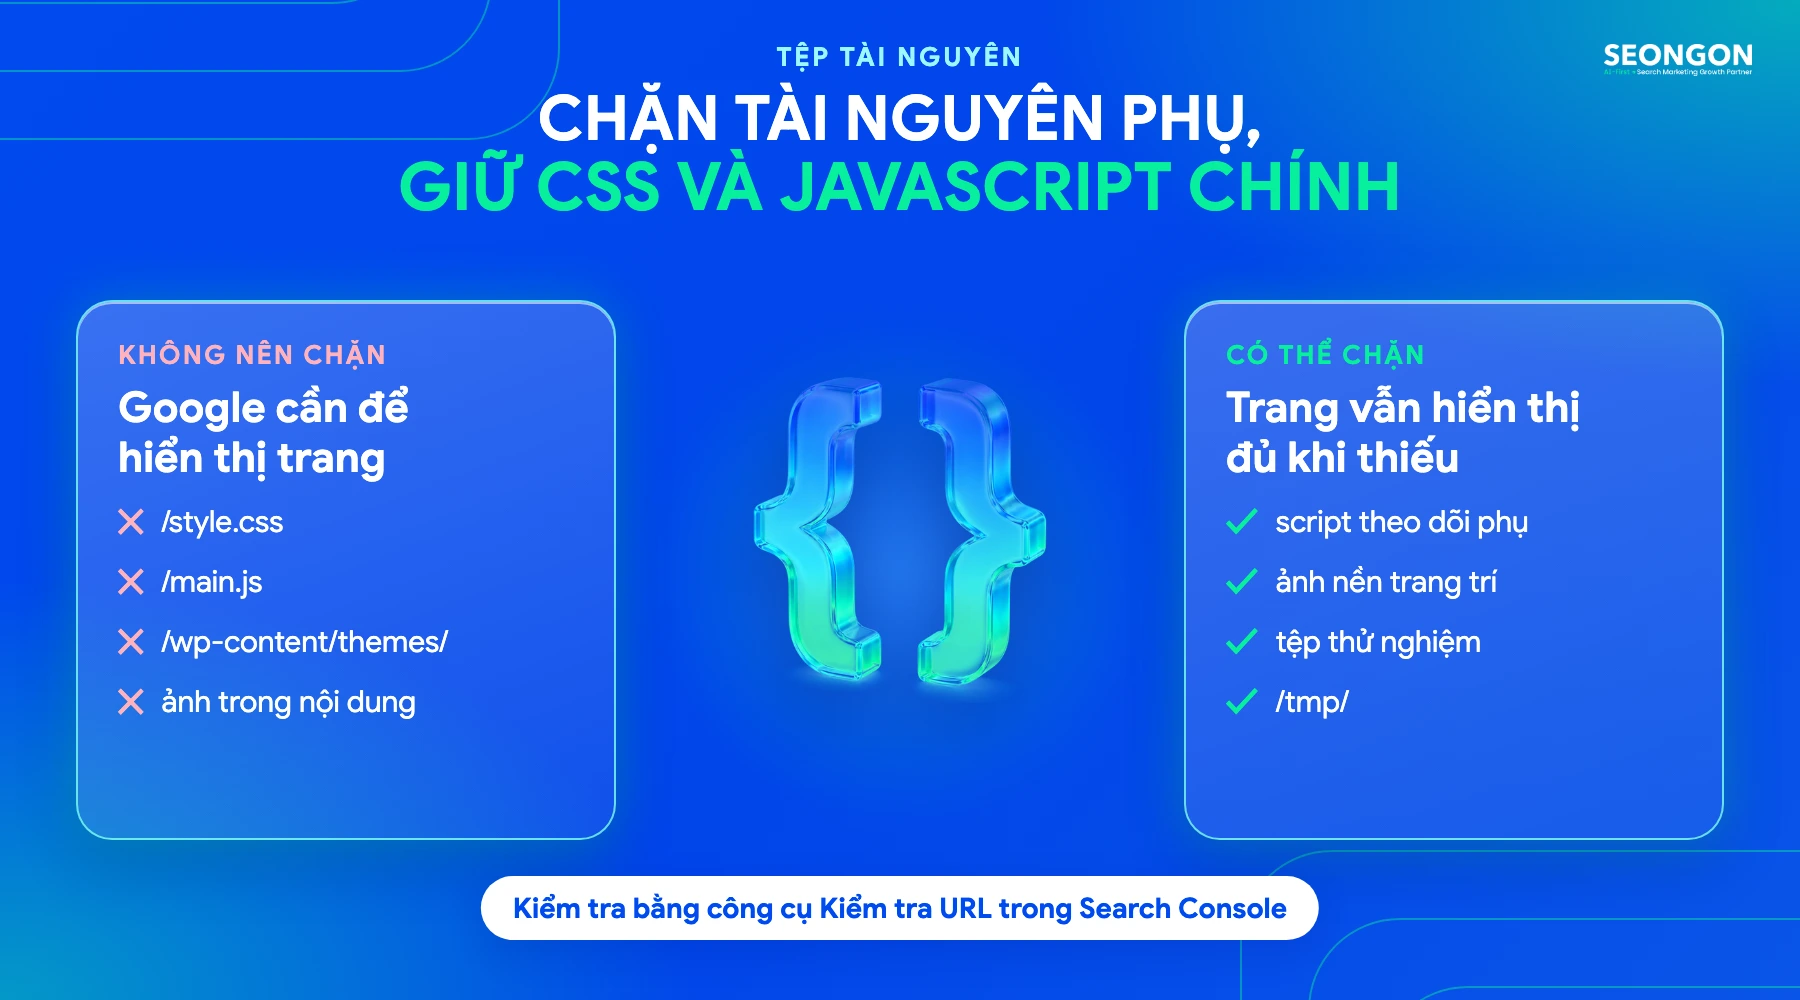
Với tệp tài nguyên, bạn có thể chặn những tệp không ảnh hưởng tới cách trang hiển thị, như script theo dõi phụ hoặc ảnh nền trang trí. Cách này giúp giảm số yêu cầu bot gửi tới máy chủ.
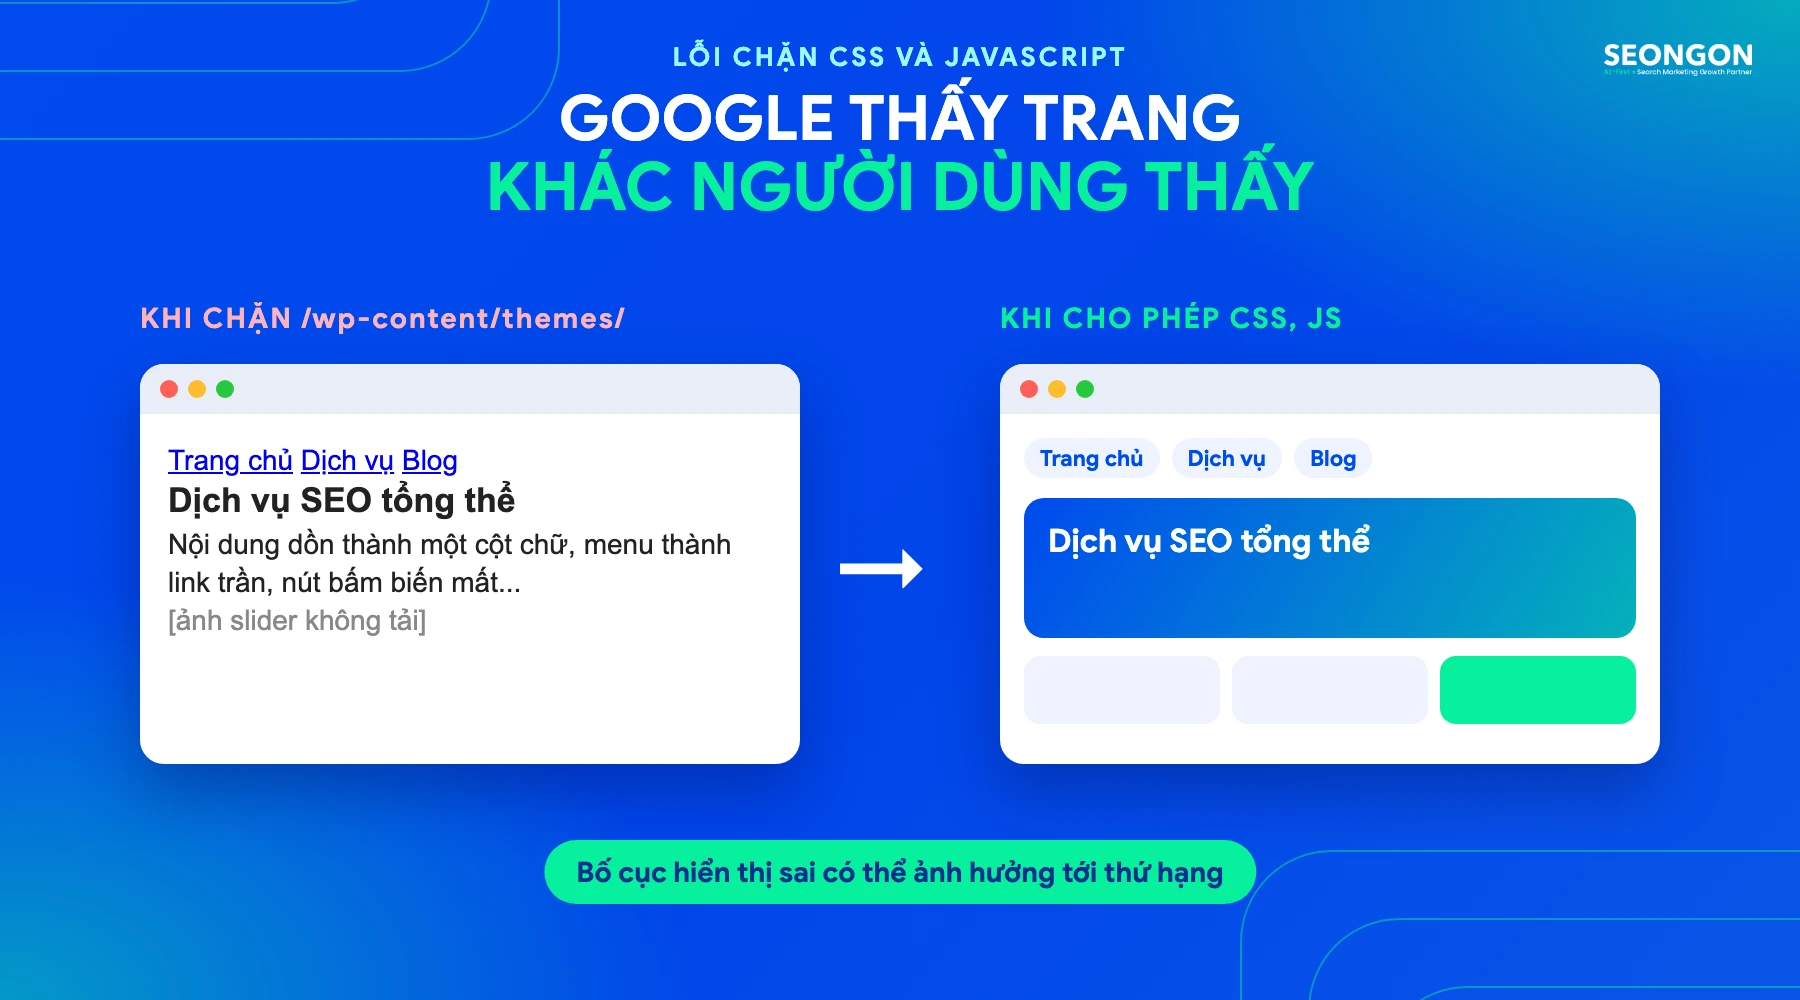
Bạn không nên chặn CSS và JavaScript chính của trang. Google cần các tệp này để hiển thị trang giống như người dùng nhìn thấy. Nếu bị chặn, Google có thể hiểu sai bố cục và nội dung, từ đó ảnh hưởng tới thứ hạng.
Robots.txt giúp bạn kiểm soát việc thu thập dữ liệu nhưng không kiểm soát được mọi thứ. Dưới đây là 4 hạn chế bạn cần biết để không đặt kỳ vọng sai vào tệp này.
Quy tắc trong robots.txt chỉ là chỉ dẫn, không phải lệnh bắt buộc. Googlebot và các bot tìm kiếm lớn làm theo quy tắc. Ngược lại, bot cào dữ liệu trái phép hoặc bot không rõ nguồn gốc có thể bỏ qua một phần hay toàn bộ quy tắc. Vì vậy trang bạn chặn vẫn có thể bị những bot này thu thập.
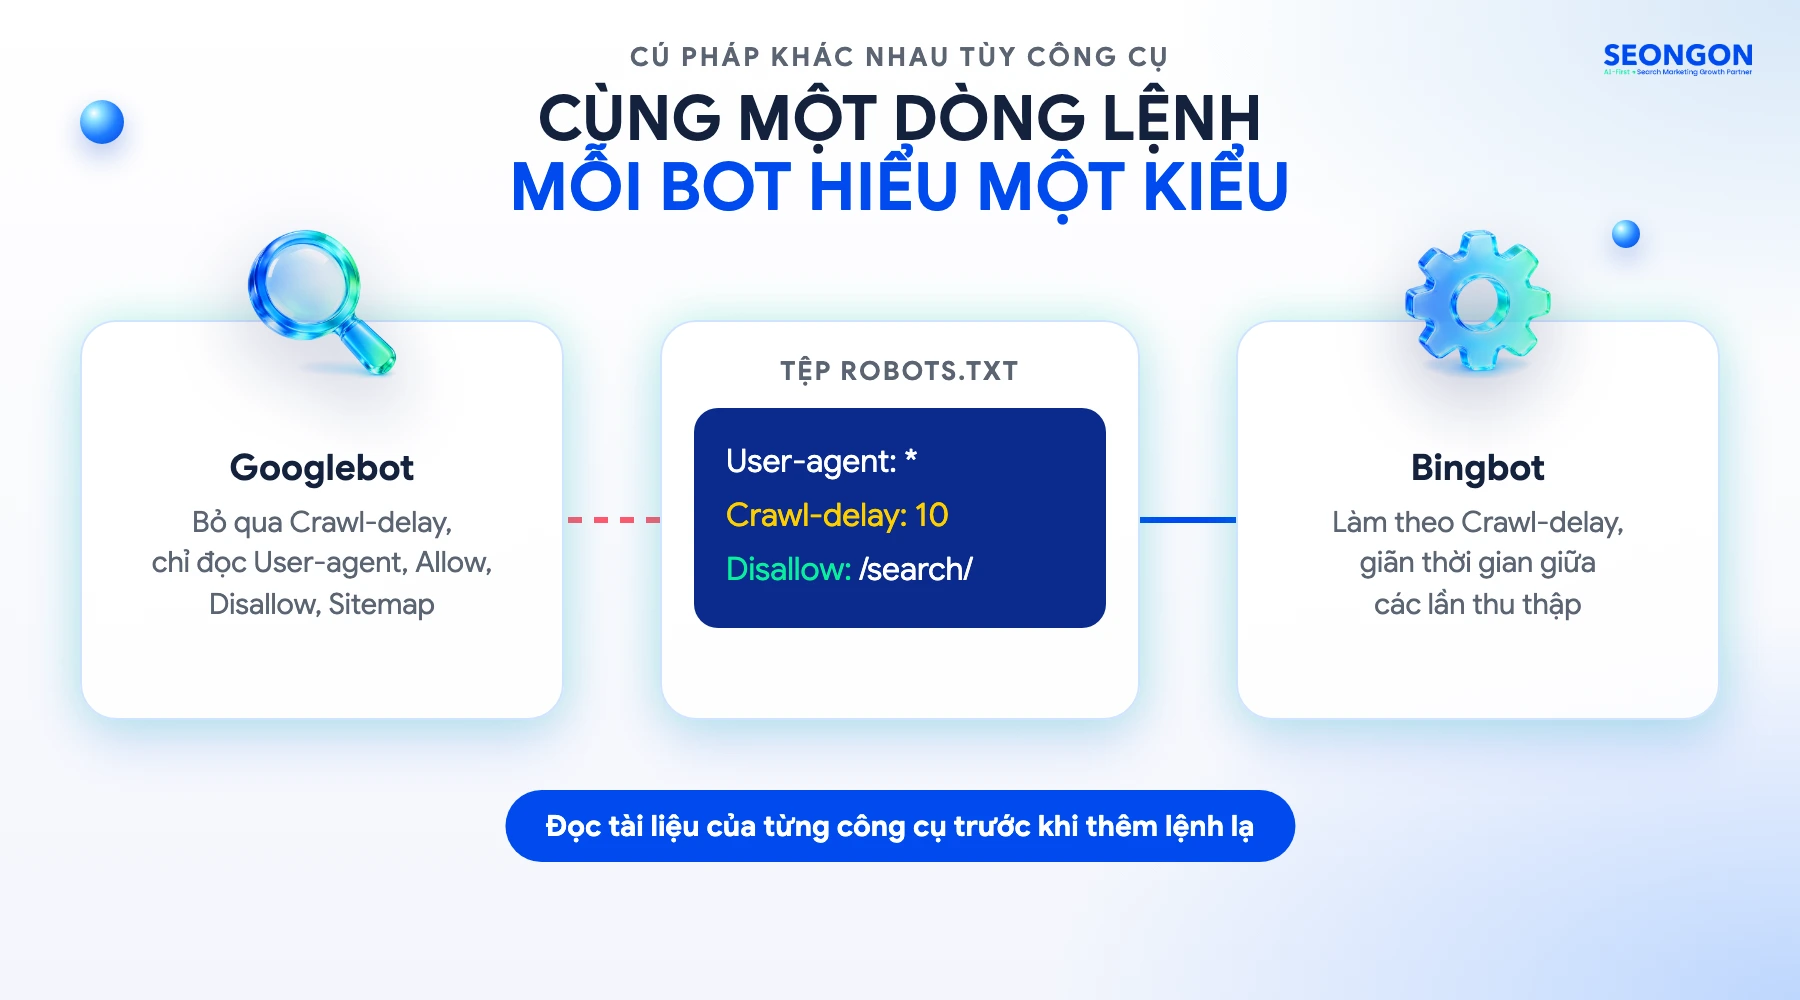
Mỗi công cụ tìm kiếm như Google, Bing, Yandex hiểu robots.txt theo cách riêng. Ví dụ lệnh Crawl-delay được Bingbot dùng để giãn thời gian giữa các lần thu thập, nhưng Googlebot bỏ qua lệnh này. Trước khi thêm một lệnh ít phổ biến, bạn nên đọc tài liệu của từng công cụ để quy tắc chạy đúng như mong muốn.
Chặn một trang trong robots.txt không ngăn hoàn toàn URL đó xuất hiện trên Google. Ví dụ trang A bị chặn nhưng trang B có liên kết tới trang A. Khi thu thập trang B, Google phát hiện URL của trang A và vẫn có thể lập chỉ mục (index) URL này, dù không đọc được nội dung bên trong.
Robots.txt là tệp công khai, ai cũng đọc được, kể cả bot xấu. Liệt kê đường dẫn nhạy cảm trong tệp còn vô tình chỉ cho người khác biết chỗ cần tìm. Nếu muốn bảo vệ hoàn toàn một trang hoặc tệp, bạn hãy kết hợp thêm các cách sau:
Với website WordPress, bạn có thể tạo robots.txt bằng plugin. Với các nền tảng khác, bạn tạo tệp thủ công rồi tải lên máy chủ. Sau khi có tệp, bạn nên kiểm tra lại trong Google Search Console để chắc chắn Google đã đọc được.
Với website WordPress, bạn có thể tạo và chỉnh robots.txt ngay trong plugin SEO mà không cần truy cập máy chủ. Nếu chưa chắc website có dùng WordPress hay không, bạn hãy thêm /wp-admin vào cuối tên miền. Khi trình duyệt chuyển đến trang đăng nhập WordPress, website của bạn đang dùng WordPress. Nếu trình duyệt báo lỗi hoặc trang không tồn tại, website dùng nền tảng khác.
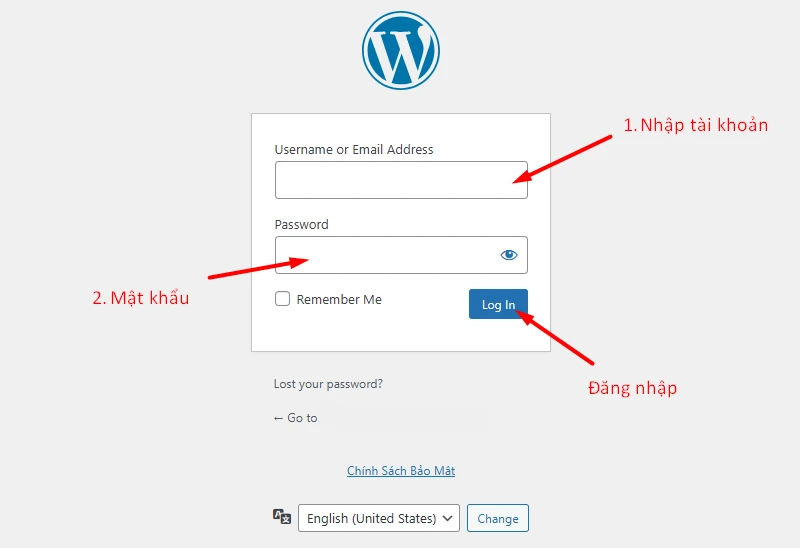
Tại trang đăng nhập, bạn nhập tên tài khoản (1), mật khẩu (2) rồi bấm Đăng nhập (Log In) để vào trang quản trị.
Sau khi đăng nhập, bạn cài plugin All in One SEO để tạo robots.txt theo các bước sau:
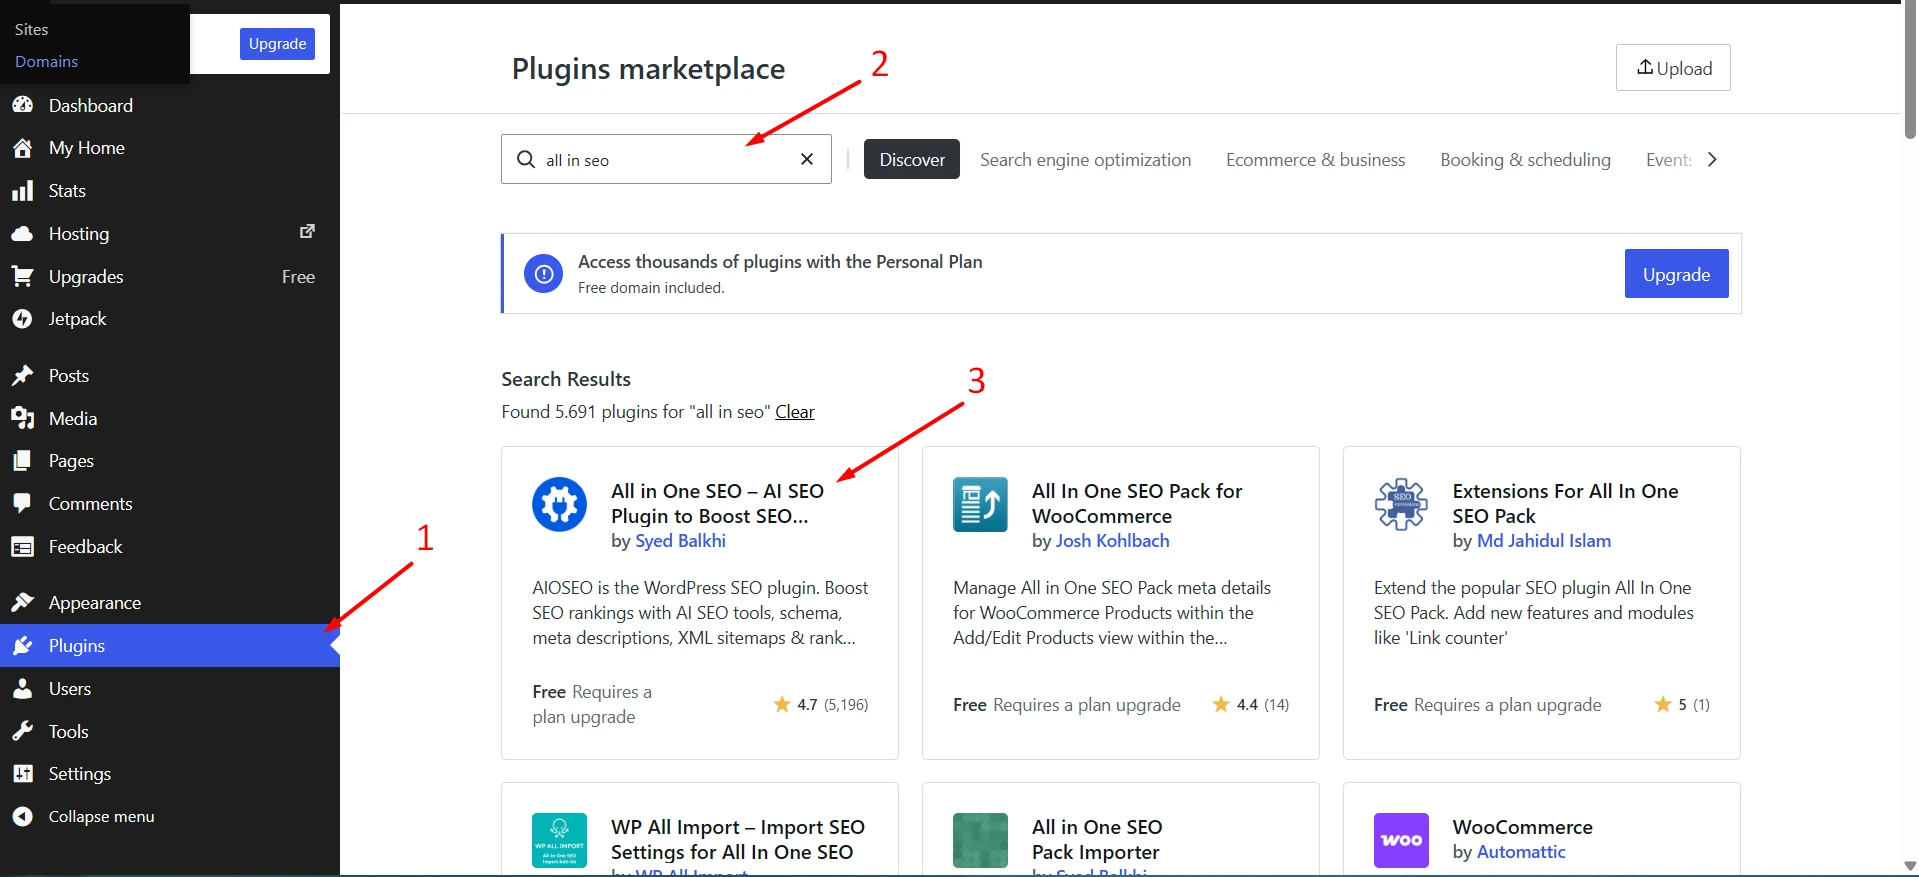
Bước 1: Ở thanh menu bên trái, bạn chọn mục Plugins (1). Tại trang tìm plugin, bạn nhập All in One SEO vào ô tìm kiếm (2).
Bước 2: Trong danh sách kết quả, bạn chọn đúng plugin All in One SEO (3) rồi bấm Cài đặt ngay.
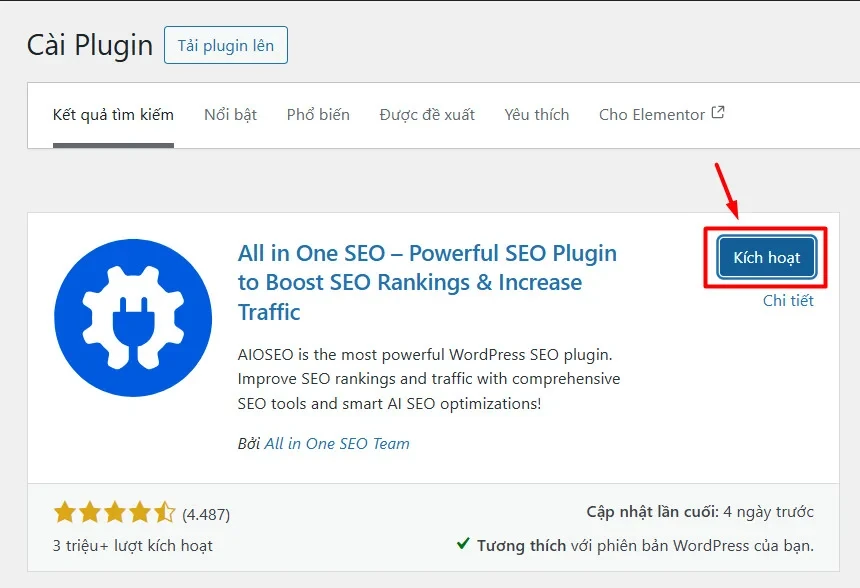
Bước 3: Khi cài đặt xong, bạn bấm Kích hoạt để bật plugin.
Bước 4: Tại menu bên trái, bạn vào All in One SEO, chọn Công cụ (Tools) để mở trình chỉnh sửa robots.txt. Sau đó bạn bật công tắc Enable Custom Robots.txt và bấm Add Rule để thêm quy tắc. Mỗi quy tắc gồm tên bot ở ô User Agent, lệnh Allow hoặc Block ở ô Directive và đường dẫn ở ô Value. Cuối cùng bạn bấm Save Changes để lưu.
Phần xem trước ở cuối trang sẽ hiện nội dung tệp sau khi bạn lưu. Nếu website đang dùng Rank Math hoặc Yoast SEO, bạn không cần cài thêm All in One SEO vì hai plugin này cũng có sẵn trình chỉnh sửa robots.txt. Bạn chỉ nên giữ một plugin SEO trên website để tránh xung đột cấu hình.
Với website lập trình riêng hoặc khi bạn muốn tự kiểm soát tệp trên máy chủ, bạn hãy tạo robots.txt thủ công theo các bước sau:
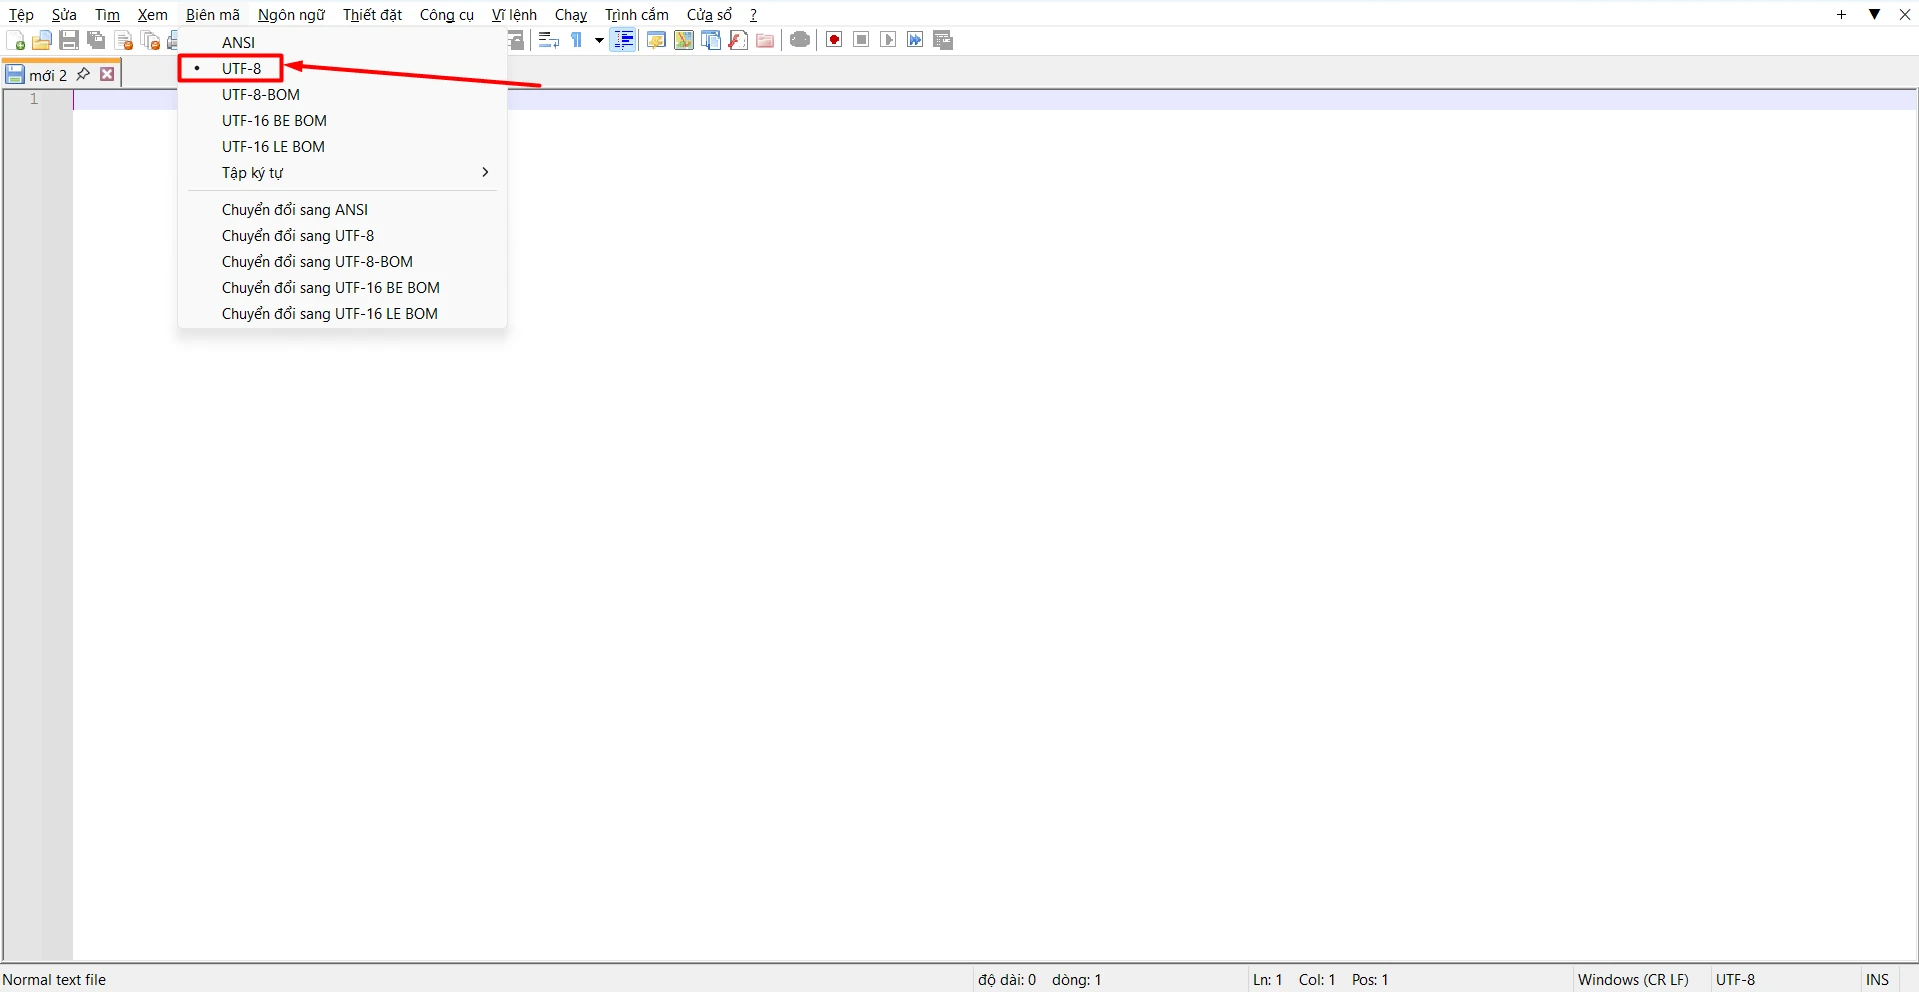
Bước 1: Bạn mở một trình soạn thảo văn bản như Notepad++ (Windows) hoặc TextEdit (macOS). Trước khi viết, bạn chọn mã hoá UTF-8 để tệp lưu đúng định dạng mà Google yêu cầu.
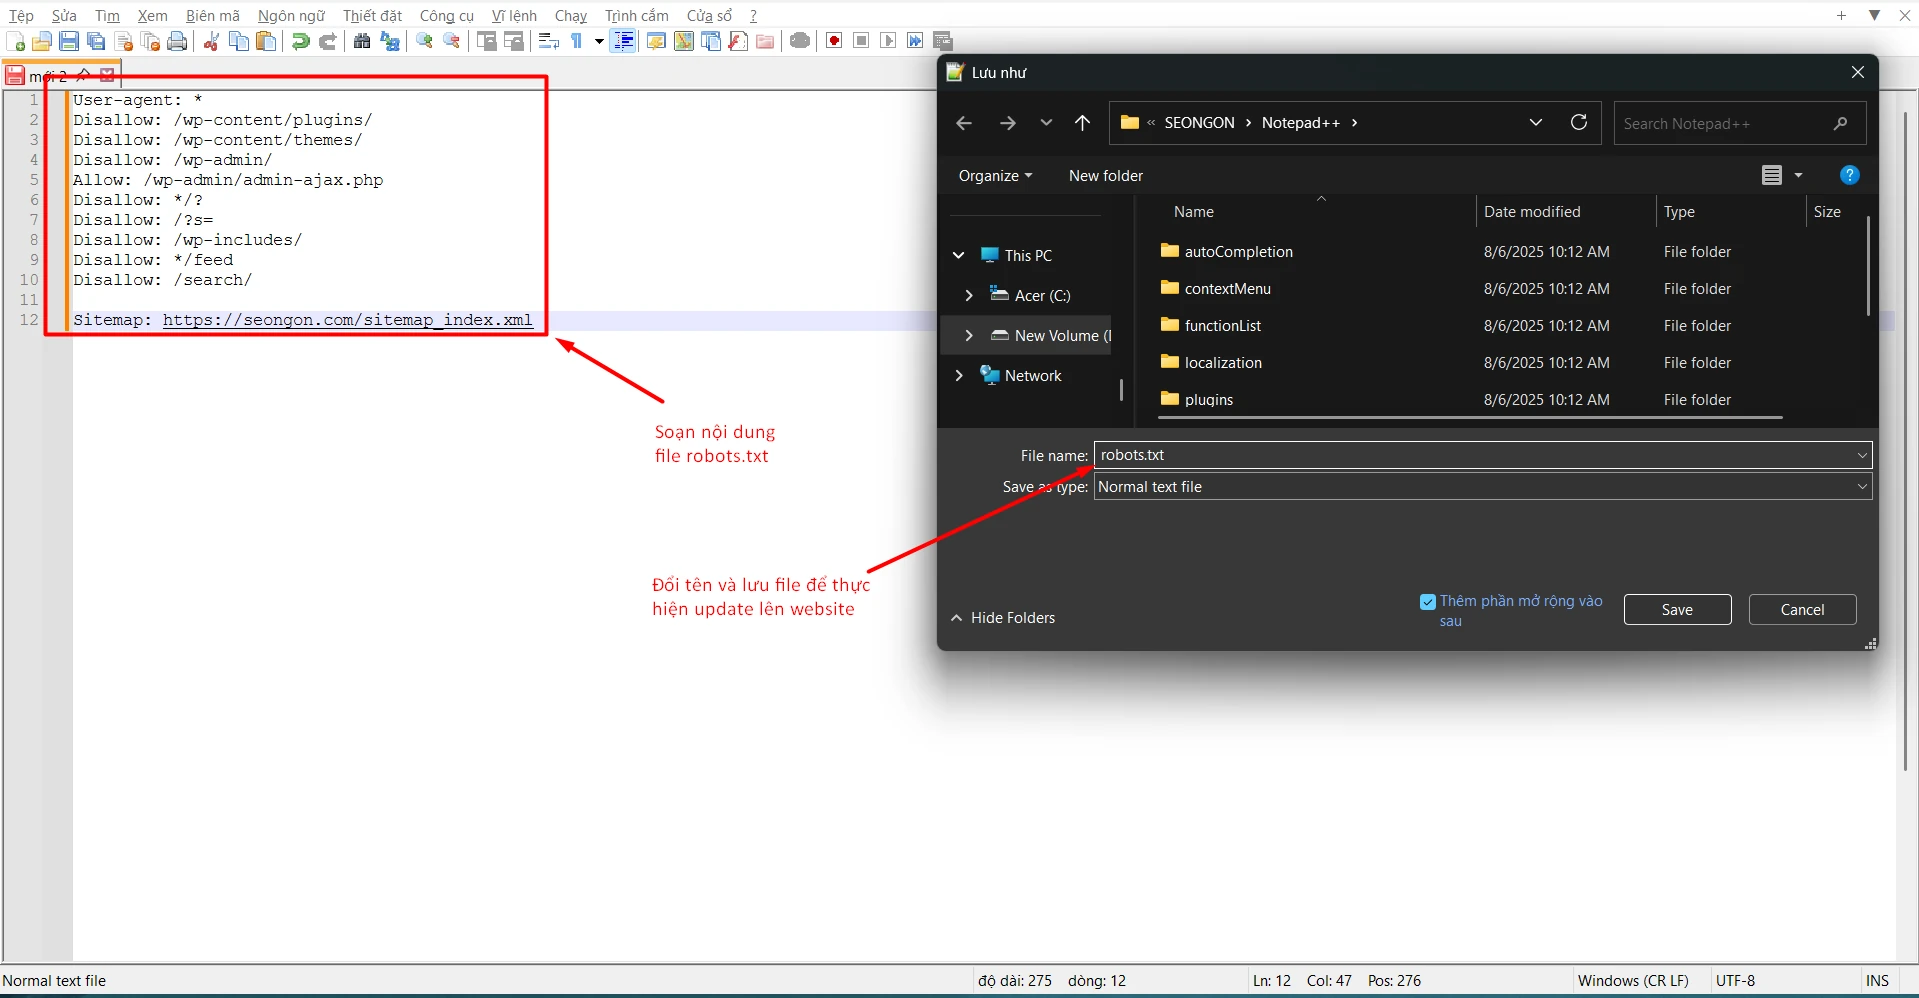
Bước 2: Bạn viết các nhóm quy tắc vào tệp, mỗi nhóm bắt đầu bằng dòng User-agent rồi đến các dòng Disallow, Allow, và thêm dòng Sitemap ở cuối. Bạn có thể dùng tệp mẫu ở mục 3.2 làm điểm bắt đầu rồi sửa đường dẫn theo website của mình.
Bước 3: Bạn lưu tệp với tên chính xác là robots.txt, viết thường toàn bộ và chọn kiểu tệp là văn bản thường (Normal text file). Mỗi tên miền chỉ có một tệp robots.txt và Google chỉ đọc tối đa 500 KiB đầu tiên của tệp.
Bước 4: Bạn tải tệp lên thư mục gốc của máy chủ, thường là thư mục public_html. Bạn có thể dùng phần mềm FTP như FileZilla hoặc trình quản lý tệp (File Manager) trong cPanel, DirectAdmin. Sau đó bạn mở tên miền/robots.txt trên trình duyệt để chắc chắn tệp đã hiển thị đúng nội dung.
Bước 5: Bạn không cần nộp robots.txt cho Google vì Googlebot tự tìm tệp ở thư mục gốc. Nếu vừa sửa tệp và muốn Google cập nhật sớm hơn chu kỳ 24 giờ, bạn hãy mở Google Search Console và chọn trang web. Kế đó bạn vào Cài đặt ở cuối menu bên trái, tại mục Thu thập thông tin bấm Mở báo cáo ở dòng robots.txt (1).
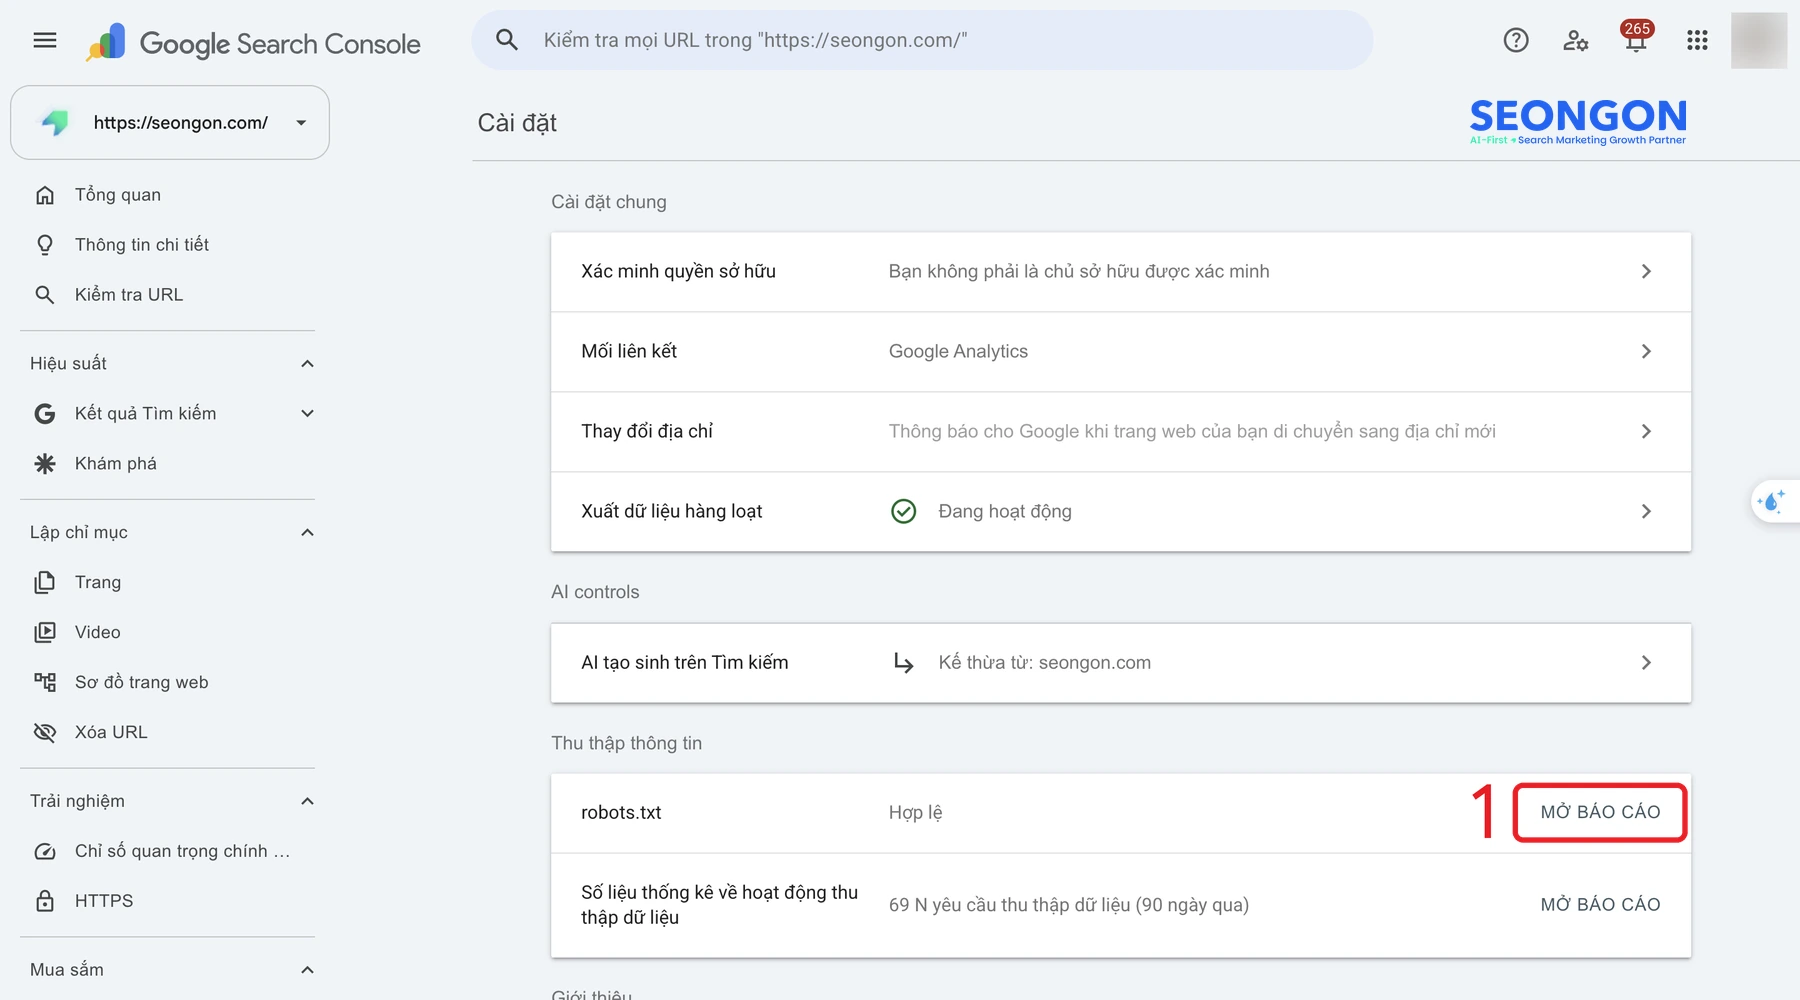
Báo cáo Tệp robots.txt cho biết thời gian Google kiểm tra gần nhất, trạng thái tìm nạp, kích thước tệp và các sự cố nếu có. Để yêu cầu Google đọc lại tệp, bạn bấm biểu tượng ba chấm ở cuối dòng (2) rồi chọn Yêu cầu thu thập lại dữ liệu (3).
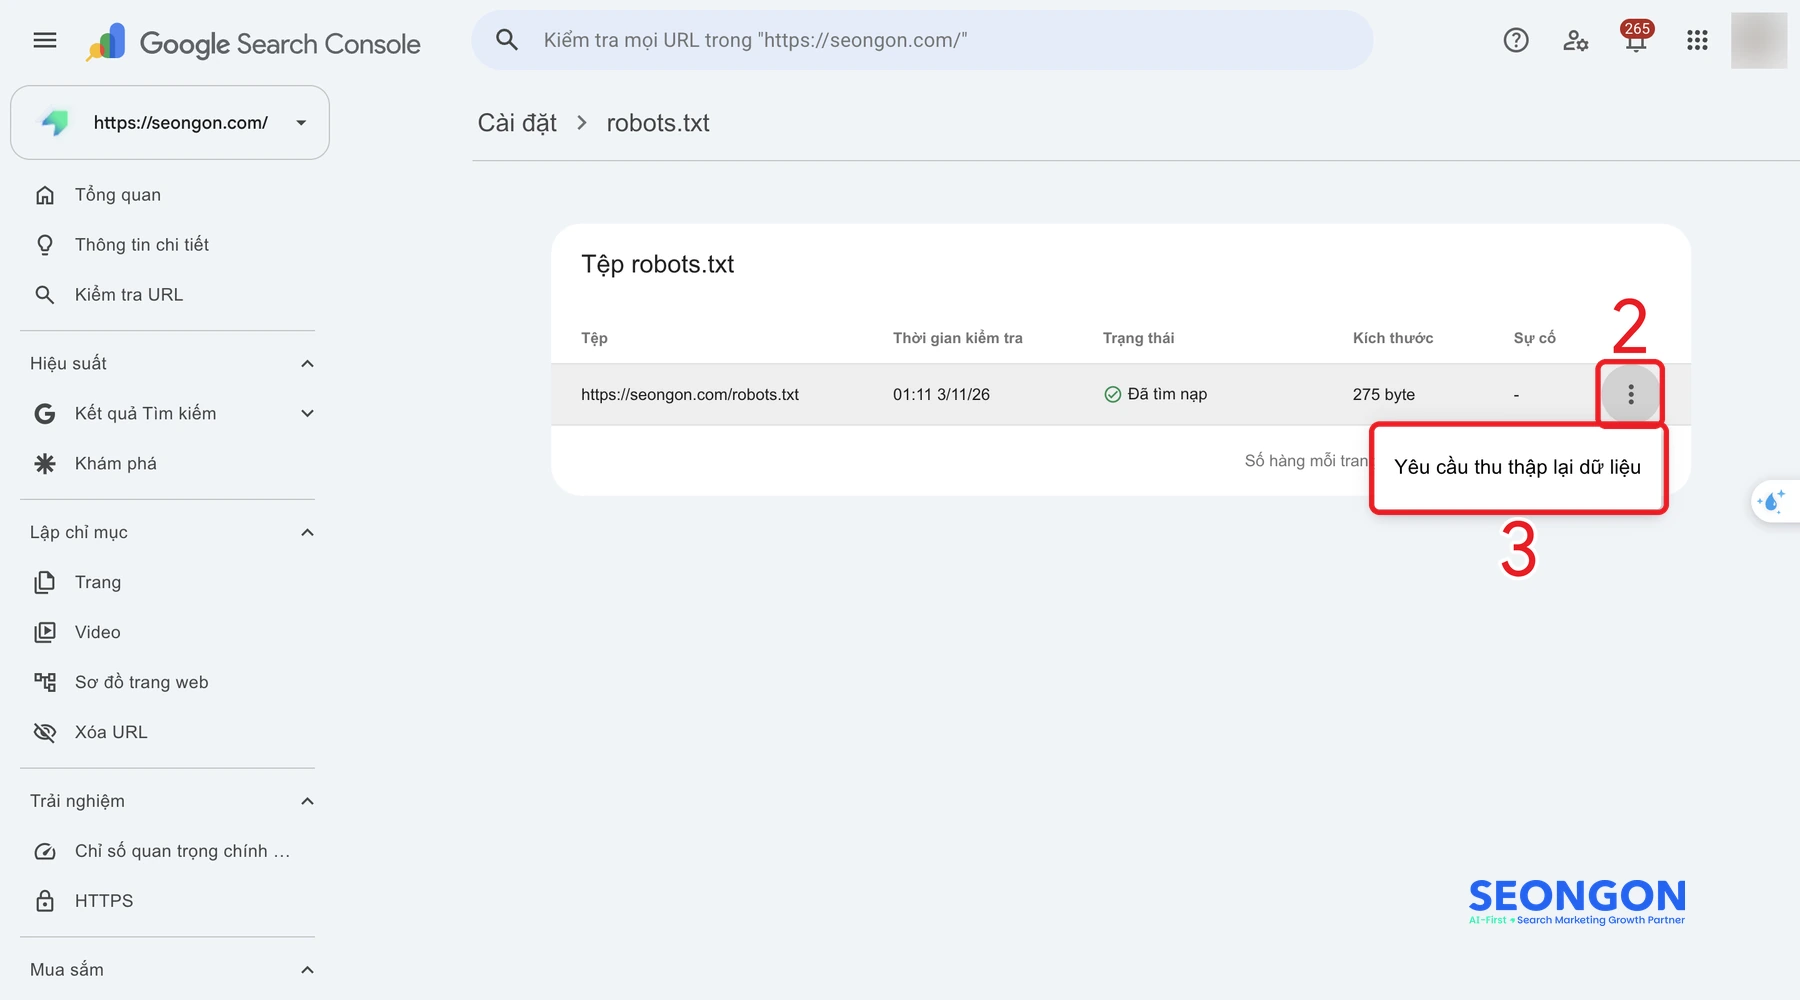
Báo cáo này thay cho công cụ Trình kiểm tra robots.txt (Robots.txt Tester) cũ mà Google đã ngừng cung cấp từ cuối năm 2023. Nếu bạn cần tư vấn cấu hình robots.txt cùng các hạng mục kỹ thuật khác cho website, bạn có thể tham khảo dịch vụ SEO của SEONGON.
Phần lớn lỗi robots.txt đến từ những thao tác nhỏ như đặt sai vị trí, viết sai ký tự hay quên xoá một dòng lệnh. Dưới đây là 8 lỗi SEONGON hay gặp khi rà soát kỹ thuật website, kèm cách khắc phục cho từng lỗi.
Đặt tệp sai vị trí là một trong những lỗi hay gặp. Khi robots.txt nằm trong thư mục con, bot không tìm thấy tệp và website hoạt động như chưa có robots.txt. Để khắc phục, bạn chỉ cần chuyển tệp về thư mục gốc rồi kiểm tra lại bằng cách mở tên miền/robots.txt.
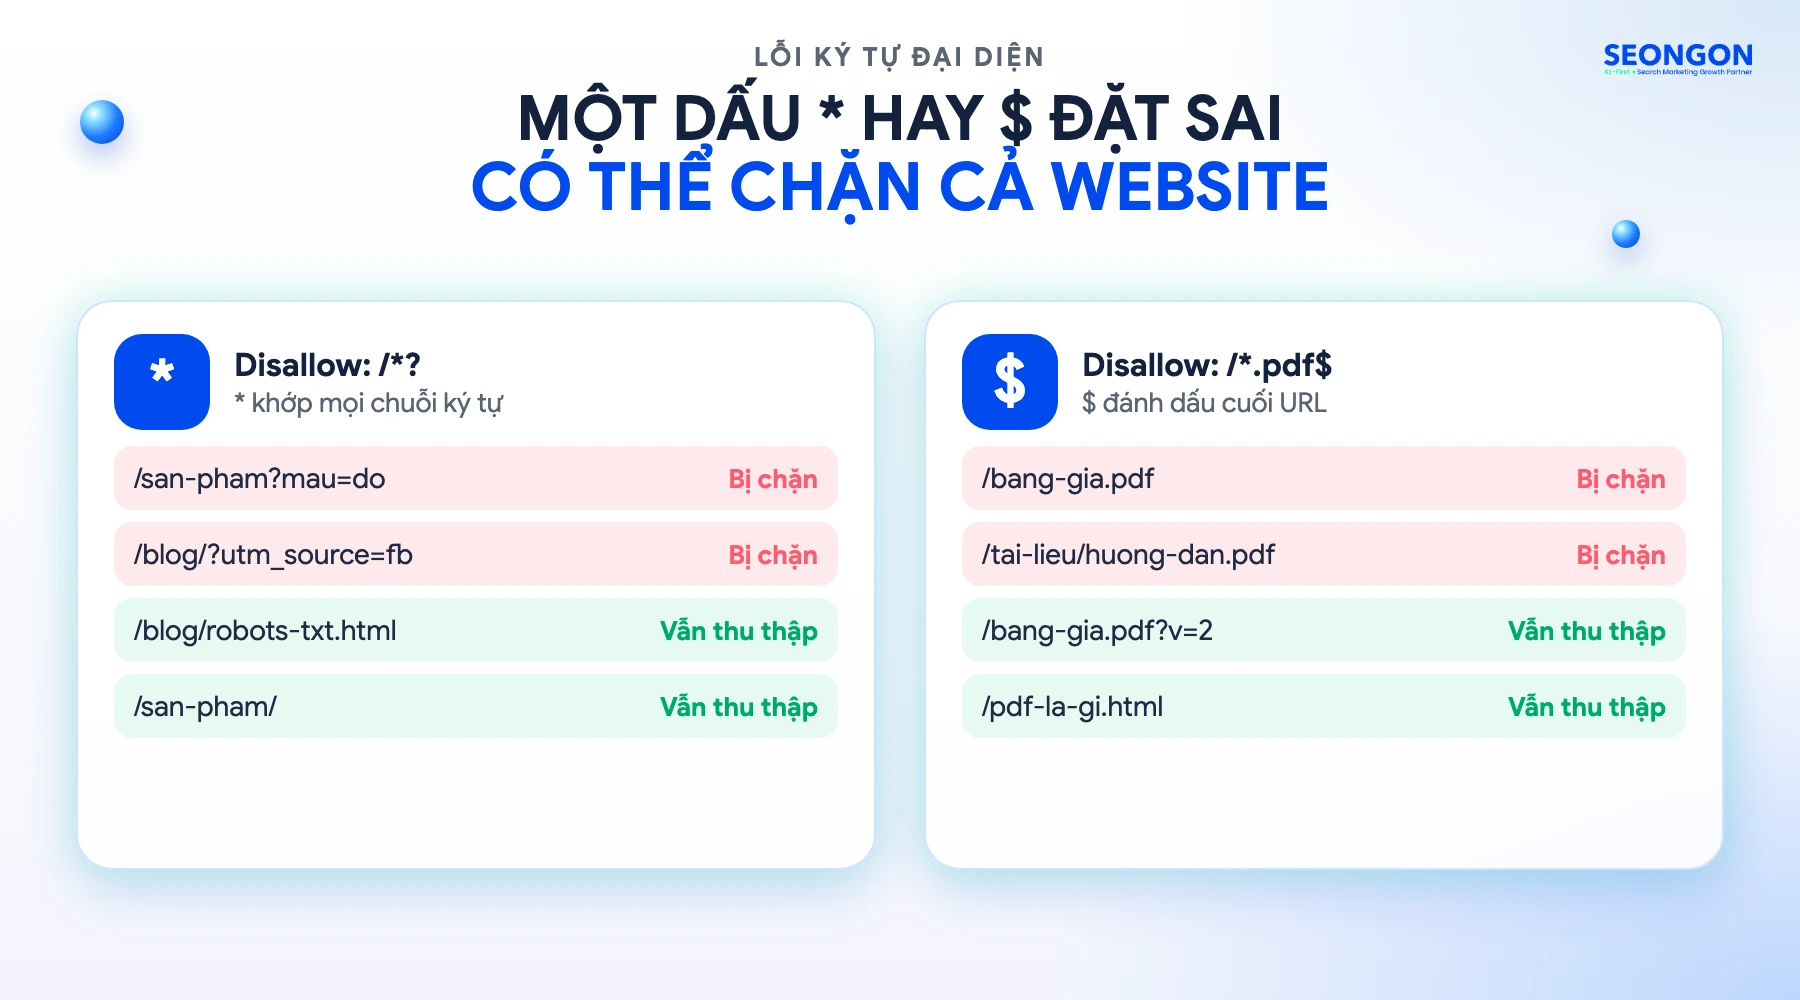
Robots.txt hỗ trợ hai ký tự đại diện là dấu sao (*) khớp với mọi chuỗi ký tự và dấu đô la ($) đánh dấu điểm kết thúc URL. Đặt sai một ký tự có thể chặn nhầm cả nhóm trang quan trọng hoặc để lọt những trang bạn muốn chặn. Vì vậy, sau khi viết quy tắc có ký tự đại diện, bạn nên thử với vài URL thật của website để chắc chắn tệp chạy đúng.
Nhiều SEOer vẫn thêm lệnh noindex vào robots.txt để ngừng lập chỉ mục trang. Google đã ngừng hỗ trợ lệnh này từ ngày 1/9/2019, nên những trang đó vẫn có thể được lập chỉ mục bình thường. Để ngăn Google lập chỉ mục một trang, bạn cần dùng thẻ meta robots hoặc HTTP header X-Robots-Tag.
Chặn tệp CSS và JavaScript khiến Google không hiển thị được trang giống người dùng nhìn thấy. Lỗi này hay xảy ra trên website WordPress khi tệp chặn cả thư mục /wp-content/themes/ hoặc /wp-content/plugins/, nơi chứa phần lớn CSS và JavaScript của giao diện. Bạn hãy dùng công cụ Kiểm tra URL trong Search Console để xem Googlebot đã thấy trang đầy đủ hay chưa. Nếu trang bị thiếu bố cục, bạn bỏ những dòng chặn tài nguyên cần thiết.
Thiếu dòng Sitemap là lỗi nhỏ nhưng nhiều website mắc phải. Google vẫn có thể tìm thấy sitemap qua Search Console, nhưng khai báo sitemap trong robots.txt giúp mọi bot tìm thấy danh sách trang quan trọng ngay khi đọc tệp. Bạn chỉ cần thêm một dòng Sitemap với URL đầy đủ ở cuối tệp.
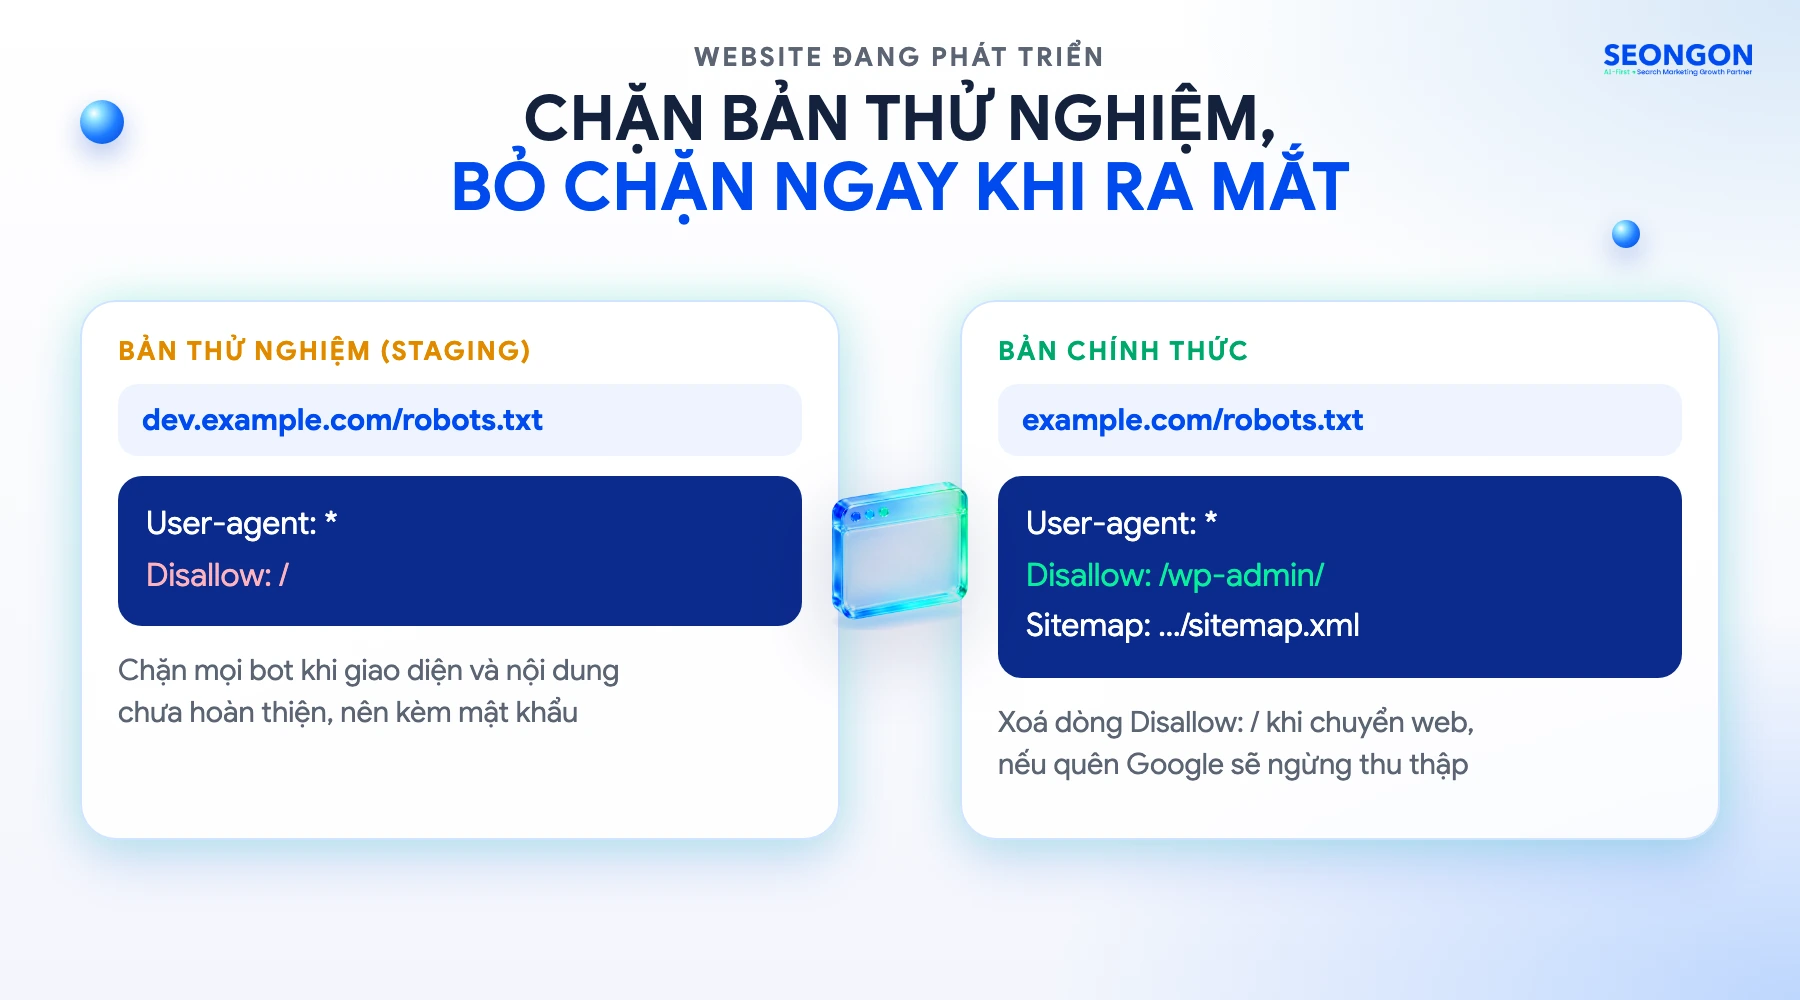
Website đang phát triển thường chưa hoàn thiện nội dung và có thể trùng lặp với website chính, vì vậy không nên để bot thu thập. Bạn có thể dùng “Disallow: /” trong robots.txt của bản thử nghiệm và đặt thêm mật khẩu. Khi website chính thức ra mắt, bạn phải xoá dòng này. Nếu quên, Google sẽ ngừng thu thập toàn bộ website mới.
Một sai lầm hay gặp là viết cả tên miền vào lệnh, ví dụ Disallow: https://example.com/admin/. Lệnh Allow và Disallow chỉ nhận đường dẫn tương đối bắt đầu bằng dấu /, ví dụ Disallow: /admin/. Riêng dòng Sitemap thì ngược lại, bắt buộc phải dùng URL đầy đủ.
Một số lệnh cũ như Crawl-delay hay Noindex không được Google hỗ trợ, nên thêm vào tệp cũng không có tác dụng với Googlebot. Bạn hãy thay bằng cách phù hợp, như dùng thẻ meta robots hoặc X-Robots-Tag để chặn lập chỉ mục. Nếu website bị Googlebot thu thập quá nhiều, bạn có thể tham khảo hướng dẫn giảm tốc độ thu thập trên Google Search Central thay vì dùng Crawl-delay.
Dưới đây là những câu hỏi SEONGON hay nhận được khi hướng dẫn khách hàng cấu hình robots.txt.
Không. Mỗi tên miền chỉ có một tệp robots.txt đặt ở thư mục gốc. Nếu website có tên miền con như blog.example.com, tên miền con đó cần một tệp robots.txt riêng.
Không. Robots.txt chỉ ngăn bot thu thập nội dung, còn URL vẫn có thể được lập chỉ mục nếu có liên kết trỏ tới. Để ẩn trang khỏi Google, bạn cần dùng thẻ noindex và để Google thu thập được trang đó để đọc thẻ.
Robots.txt cho bot biết phần nào được và không được thu thập. Sitemap.xml là danh sách các URL quan trọng bạn muốn bot thu thập. Hai tệp bổ trợ cho nhau và bạn có thể khai báo sitemap ngay trong robots.txt.
Bạn có thể để trống tệp hoặc dùng hai dòng sau để cho phép mọi bot thu thập toàn bộ website:
User-agent: *
Disallow:
Không nên chặn nếu bạn muốn website được nhắc tới và trích dẫn trong câu trả lời của AI. Ví dụ OpenAI dùng GPTBot để thu thập dữ liệu huấn luyện và OAI-SearchBot để hiển thị website trong kết quả tìm kiếm của ChatGPT. Nếu chỉ không muốn nội dung bị dùng để huấn luyện, bạn chặn riêng GPTBot và vẫn giữ OAI-SearchBot.
File robots.txt chỉ vài dòng nhưng quyết định bot được thu thập phần nào của website. Bạn hãy kiểm tra tệp mỗi khi đổi giao diện, cài plugin mới hoặc chuyển website. Song song đó, bạn theo dõi báo cáo robots.txt trong Search Console để phát hiện sớm lỗi chặn nhầm. Nếu muốn rà soát thêm các lỗi kỹ thuật khác, bạn có thể đọc bài 40+ lỗi technical SEO phổ biến của SEONGON.
Với kinh nghiệm triển khai thành công hàng nghìn chiến dịch quảng cáo chuyển đổi,
SEONGON tự tin có thể giúp bạn tối ưu hiệu quả và tiết kiệm chi phí tối đa với hoạt động quảng cáo.


Hãy để SEONGON
hiểu hơn về bạn
SEONGON luôn sẵn sàng lắng nghe và cùng bạn tìm ra giải pháp phù hợp nhất